

Một trợ lý AI cho bộ phận chăm sóc khách hàng vượt qua buổi demo rất đẹp.
Nó phân loại đúng yêu cầu. Nó viết câu trả lời lịch sự. Nó còn biết gọi công cụ tra cứu hóa đơn.
Một tuần sau khi triển khai, trợ lý báo với khách rằng khoản hoàn tiền đã được xử lý. Câu trả lời rất tự tin, đúng giọng thương hiệu, không sai chính tả. Chỉ có một vấn đề: nó chưa hề gọi hệ thống thanh toán, và tiền chưa được hoàn.
Nếu đội dự án chỉ chấm “độ hữu ích” của câu trả lời, lỗi này có thể được điểm cao. Nếu chỉ xem benchmark của model, lỗi này thậm chí không xuất hiện. Thứ hỏng không đơn thuần là model. Thứ hỏng là cả hệ thống ra quyết định quanh model.
Đó là điểm xuất phát quan trọng nhất của LLM evaluation trong môi trường thật:
Đánh giá AI không phải là tìm một con số mô tả model. Đánh giá là thu thập đủ bằng chứng để quyết định: triển khai, chặn, điều tra, giảm phạm vi hay quay lui.
Bạn đang đánh giá model hay sản phẩm?
Một ứng dụng LLM đưa vào doanh nghiệp luôn lớn hơn model nằm bên trong nó. Hành vi người dùng nhìn thấy là kết quả của cả một cấu hình:
model và phiên bản model;
system prompt và prompt nghiệp vụ;
dữ liệu được truy xuất;
công cụ mà AI được phép gọi;
chính sách và quyền hạn;
định dạng đầu ra;
temperature, giới hạn token, retry và timeout;
code điều phối các bước;
trạng thái thật của các hệ thống bên ngoài.
Thay một thành phần, hành vi có thể đổi. Cùng một model nhưng prompt khác, kho tri thức cũ hơn một tuần hoặc schema của công cụ vừa thay đổi đã là một hệ thống khác.
Nếu muốn nhìn cấu hình đó như một kiến trúc hoàn chỉnh thay vì một cửa sổ chat, bạn có thể xem thêm bản thiết kế bốn tầng biến Claude Code thành hệ thống làm việc.
Vì vậy cần tách ba câu hỏi thường bị trộn lẫn:
Đánh giá model: model nền có năng lực tổng quát phù hợp với nhiệm vụ không?
Đánh giá hệ thống: cấu hình cụ thể gồm model, prompt, dữ liệu, công cụ và chính sách có hoàn thành công việc đúng yêu cầu không?
Giám sát vận hành: sau khi lên môi trường thật, hệ thống có tiếp tục an toàn và ổn định trước dữ liệu mới không?
Benchmark có ích cho câu hỏi đầu. Nhưng quyết định phát hành một trợ lý hoàn tiền, một copilot nội bộ hay một quy trình agent phải dựa chủ yếu vào câu hỏi thứ hai và thứ ba.
Nói cách khác, điểm thi của động cơ không thay thế được bài kiểm tra chiếc xe đã lắp hoàn chỉnh.
Một câu trả lời “hay” vẫn có thể là một kết quả tệ
Các đội mới làm AI thường bắt đầu bằng một bảng chấm kiểu: đúng, hữu ích, rõ ràng, thân thiện. Đây là những tiêu chí cần thiết, nhưng chưa đủ.
Một sản phẩm AI chỉ thật sự “hoạt động” khi đồng thời đạt bốn trục:
Trục
Câu hỏi cần trả lời
Ví dụ tín hiệu
Chất lượng
Kết quả có đúng mục tiêu và hữu ích không?
độ chính xác phân loại, tính đầy đủ, tỷ lệ người dùng chấp nhận
An toàn
Có vi phạm chính sách, lộ dữ liệu hay tạo tuyên bố không có căn cứ không?
tỷ lệ vi phạm, PII leakage, hành động vượt quyền
Chi phí
Giá cho mỗi tác vụ và tổng tải có nằm trong ngân sách không?
token, số lần gọi tool, chi phí trên case
Độ tin cậy
Hệ thống có chạy ổn định dưới điều kiện thật không?
latency p95, timeout, tool success, tỷ lệ fallback
Một model mới có thể viết hay hơn nhưng chậm gấp đôi. Một prompt mới có thể tăng tỷ lệ giải quyết yêu cầu phổ thông nhưng làm hỏng nhóm khiếu nại pháp lý. Một agent có thể hoàn thành 94% tác vụ, nhưng 6% còn lại tự ý thực hiện hành động tài chính.
Không có điểm trung bình nào tự nói cho ta biết các đánh đổi đó có chấp nhận được hay không.
Metric là bằng chứng. Threshold biến bằng chứng thành điều kiện. Gate nối điều kiện với hành động.
Ví dụ:
Điểm giọng văn dưới 4/5: cho phép triển khai giới hạn và theo dõi.
Latency p95 vượt 8 giây: chưa chặn, nhưng phải tối ưu trước khi mở rộng.
Có một tuyên bố “đã hoàn tiền” mà không có tool call thành công: chặn phát hành.
Tỷ lệ vi phạm chính sách nhóm rủi ro cao lớn hơn 0% trong canary: quay lui.
Các ngưỡng không thể lấy từ một bài viết rồi áp cho mọi công ty. Chúng phải phản ánh hậu quả kinh doanh thật. Lỗi dấu câu và lỗi phê duyệt khoản hoàn tiền không được đối xử như nhau.
Hai người dùng, hai cách học đánh giá AI
Ví dụ 1: Một học sinh năm thứ 3
Minh là học sinh năm thứ 3 ngành kinh doanh. Nhóm của Minh làm bài tập xây chatbot tư vấn môn học cho sinh viên.
Lần đầu, nhóm chọn 30 câu hỏi, chạy chatbot một lần rồi nhờ một model khác chấm “mức hữu ích” từ 1 đến 10. Kết quả 8,6 điểm. Cả nhóm nghĩ sản phẩm đã tốt.
Nhưng Minh thử hỏi bằng tiếng Việt không dấu, viết tắt tên môn và cố tình đưa hai yêu cầu trong cùng một câu. Chatbot chọn sai môn tiên quyết. Ở câu khác, nó bịa ra lịch học chưa được nhà trường công bố.
Minh nhận ra con số 8,6 đang giấu nhiều chuyện. Bạn làm lại bộ kiểm thử theo từng slice:
câu hỏi đủ thông tin và thiếu thông tin;
tiếng Việt chuẩn, không dấu và có lỗi gõ;
một ý định và nhiều ý định;
thông tin ổn định và thông tin phải tra cứu mới nhất;
câu hỏi bình thường và yêu cầu có dữ liệu cá nhân.
Mỗi case ghi rõ hành vi mong đợi, chứ không ép chatbot phải viết đúng một câu mẫu. Với lịch chưa công bố, hành vi đúng là nói chưa đủ căn cứ và chỉ nguồn chính thức — không phải đoán ra một ngày nghe có vẻ hợp lý.
Nhóm Minh cũng tách cách chấm:
kiểm tra bằng code xem đường dẫn và mã môn có hợp lệ không;
so nhãn với đáp án chuẩn cho phần phân loại;
dùng rubric để chấm sự rõ ràng của câu trả lời;
nhờ con người xem các trường hợp mơ hồ hoặc liên quan dữ liệu cá nhân.
Kết quả tổng hợp giảm từ 8,6 xuống 7,4. Nhưng đây lại là bước tiến: nhóm biết hệ thống yếu ở đâu, sửa gì trước và điều kiện nào phải đạt trước khi demo.
Ví dụ 2: Một nhân viên mới có một năm kinh nghiệm
Lan làm chăm sóc khách hàng được một năm. Công ty thử nghiệm AI để phân loại khiếu nại và soạn phản hồi.
Lan không xây model, nhưng Lan biết những ngoại lệ mà bộ tài liệu quy trình thường không kể hết: đơn giao một phần, mã vận đơn đổi giữa chặng, khách thuộc chương trình đối tác, hay khoản bồi hoàn cần trưởng nhóm duyệt.
Trong bản thử đầu, báo cáo chỉ có “độ chính xác 93%”. Lan hỏi một câu rất đơn giản:
7% sai nằm ở những yêu cầu nào?
Hóa ra phần lớn lỗi tập trung ở nhóm đơn hàng có giá trị cao và case phải kiểm tra công cụ vận chuyển. Đây là slice ít xuất hiện nên gần như biến mất trong số trung bình, nhưng hậu quả của nó lại lớn hơn hẳn.
Lan cùng đội kỹ thuật biến những tình huống thật thành case có cấu trúc:
yaml
case_id: refund_missing_order_id_014
risk_tier: medium
input: "Tôi bị trừ tiền hai lần, hoàn lại giúp tôi."
tool_condition: billing_lookup_required
expected_behavior:
  - không xác nhận đã hoàn tiền
  - yêu cầu mã đơn hoặc thông tin định danh còn thiếu
  - giải thích cần xác minh giao dịch trước
  - chuyển người duyệt nếu số tiền vượt hạn mức
Sau đó, mỗi lỗi production được thêm vào regression suite. Một tháng sau, Lan không còn chỉ là người “test hộ”. Bạn trở thành người thiết kế bằng chứng nghiệp vụ cho quyết định phát hành.
Hai ví dụ này cho thấy một điều: làm evaluation không bắt đầu bằng việc chọn model chấm điểm. Nó bắt đầu bằng việc hiểu thất bại nào đáng sợ, dữ liệu nào đại diện và hành vi nào được xem là chấp nhận được.
Bộ từ vựng tối thiểu để cả đội nói cùng một ngôn ngữ
Một chương trình đánh giá dễ rối khi sản phẩm, kỹ thuật và nghiệp vụ dùng cùng một từ cho những thứ khác nhau. Có thể bắt đầu bằng các “viên gạch” sau:
Case: một tình huống kiểm thử gồm input, bối cảnh, hành vi mong đợi và metadata.
Run: một lần chạy case trên một cấu hình hệ thống cụ thể.
Trace: toàn bộ dấu vết trung gian — truy xuất gì, gọi tool nào, nhận kết quả gì, retry ra sao.
Evaluator: cơ chế biến output hoặc trace thành phán đoán.
Metric: cách tổng hợp các phán đoán thành tín hiệu.
Slice: nhóm case có chung thuộc tính cần quan sát riêng.
Suite: tập case phục vụ một mục tiêu kiểm thử.
Threshold: ngưỡng chấp nhận của một tín hiệu.
Gate: quy tắc dùng một hoặc nhiều ngưỡng để ra hành động.
Điểm thường bị bỏ quên là metadata và versioning. Mỗi run nên gắn với model version, prompt version, snapshot dữ liệu truy xuất, schema tool, policy version, evaluator version, test-suite version và commit code.
Nếu hôm qua hệ thống đạt 92% còn hôm nay chỉ 87%, đội phải trả lời được “thứ gì đã thay đổi”. Không lưu danh tính đầy đủ của run thì evaluation trở thành ảnh chụp không có ngày tháng.
Trace cũng quan trọng không kém câu trả lời cuối. Nếu AI nói “đã hoàn tiền”, chỉ nhìn output ta biết câu đó có vẻ ổn. Nhìn trace, ta mới biết trước đó công cụ thanh toán đã trả về thành công, thất bại hay chưa từng được gọi.
Đừng tìm một evaluator hoàn hảo
Không có một người chấm nào phù hợp với mọi loại lỗi. Cách bền vững hơn là xếp evaluator thành nhiều lớp, từ rẻ và chắc đến đắt và giàu phán đoán.
1. Kiểm tra xác định
Dùng code cho những gì có thể trả lời đúng hoặc sai rõ ràng:
JSON có đúng schema không?
Trường bắt buộc có tồn tại không?
ID có hợp lệ không?
Tool argument có vượt quyền không?
Một tuyên bố hành động có đi sau tool result thành công không?
Đừng dùng LLM judge để làm việc mà vài dòng code có thể kiểm tra chính xác hơn.
2. So sánh với tham chiếu
Phù hợp với phân loại, trích xuất có cấu trúc, định tuyến hoặc những phần có nhãn chuẩn. Với nội dung mở, một câu trả lời khác đáp án mẫu chưa chắc là sai, nên không nên ép toàn bộ hệ thống vào “single ground truth”.
3. LLM-as-judge
Hữu ích khi đánh giá giọng văn, độ rõ, tính đầy đủ hoặc so sánh hai phiên bản. Nhưng judge cũng là một model: có thiên lệch, có dao động và có thể đổi hành vi khi model phía sau được cập nhật.
Một rubric tốt phải mô tả từng mức điểm, đưa ví dụ biên và tách các tiêu chí thay vì hỏi chung chung “câu trả lời này có tốt không?”. Judge cần được hiệu chỉnh định kỳ với nhãn con người.
4. Đánh giá của con người
Dành cho case rủi ro cao, mơ hồ, liên quan chính sách mới hoặc nơi các evaluator bất đồng. Con người đắt và chậm hơn, nhưng đó không phải lý do để loại họ khỏi hệ thống. Mục tiêu là đưa con người vào đúng điểm cần phán đoán, không bắt họ đọc mọi output.
Nguyên tắc chọn rất đơn giản:
Bắt đầu từ failure mode, rồi mới chọn evaluator.
Muốn phát hiện tool không được gọi thì xem trace. Muốn kiểm tra schema thì dùng validator. Muốn biết câu trả lời có đồng cảm phù hợp không thì dùng rubric và lấy mẫu cho con người. Sai lầm phổ biến là mua một công cụ chấm điểm trước, rồi cố biến mọi rủi ro thành thứ công cụ đó đo được.
Dataset tốt không chỉ có những câu “đúng bài”
Một bộ test toàn câu dễ sẽ tạo cảm giác tiến bộ rất nhanh. Đến production, traffic thật phá vỡ cảm giác đó.
Bộ đánh giá tối thiểu nên có bốn nhóm:
Representative set: phản ánh phân phối tác vụ thường gặp.
Critical slices: nhóm ít gặp nhưng có hậu quả cao hoặc hành vi khác biệt.
Adversarial set: cố ý gây nhiễu, vượt quyền, prompt injection hoặc đưa dữ liệu mâu thuẫn.
Regression set: các lỗi đã từng xảy ra và không được phép quay lại.
Có thể dùng dữ liệu tổng hợp để mở rộng độ phủ, nhưng phải coi đó là giả thuyết về traffic chứ không phải bản sao của production. Dữ liệu tổng hợp thường mang dấu vết của model tạo ra nó và dễ bỏ qua những cách người thật diễn đạt “xấu xí”.
Hãy giữ một phần hold-out không dùng để tối ưu prompt hằng ngày. Nếu cả đội nhìn đi nhìn lại cùng 100 case, họ sẽ dần tối ưu cho bài thi thay vì cho sản phẩm.
Và đừng chỉ báo cáo điểm toàn cục. Nếu tiếng Việt đạt 95% nhưng tiếng Việt không dấu chỉ đạt 62%, số 91% trung bình không giúp đội ra quyết định đúng. Báo cáo theo slice chính là cách ngăn nhóm thiểu số và tình huống rủi ro bị che khuất.
LLM không ổn định: một lần chạy chưa phải kết luận
Cùng input và cùng cấu hình, hệ thống sinh có thể cho ra các kết quả khác nhau. Tool bên ngoài cũng có lúc chậm, lỗi hoặc trả dữ liệu thay đổi.
Vì vậy một kết quả duy nhất không đủ để kết luận phiên bản A tốt hơn B.
Với metric dễ dao động, hãy:
chạy lặp lại trên các case quan trọng;
giữ cố định cấu hình khi so sánh;
báo khoảng bất định thay vì chỉ báo trung bình;
dùng paired comparison trên cùng tập case;
phân biệt thay đổi có ý nghĩa với nhiễu ngẫu nhiên;
theo dõi chính evaluator vì judge cũng có thể drift.
Không nhất thiết phải biến mỗi release thành một luận văn thống kê. Nhưng nếu hai phiên bản chênh nhau 0,4 điểm trong khi độ dao động thường là 1,2 điểm, đội không nên tuyên bố chiến thắng.
Một gate tốt cũng không chỉ hỏi “điểm có giảm không?”. Nó hỏi mức giảm lớn đến đâu, nằm ở slice nào, có lặp lại không và hậu quả kinh doanh là gì.
Từ bài test đến cổng triển khai
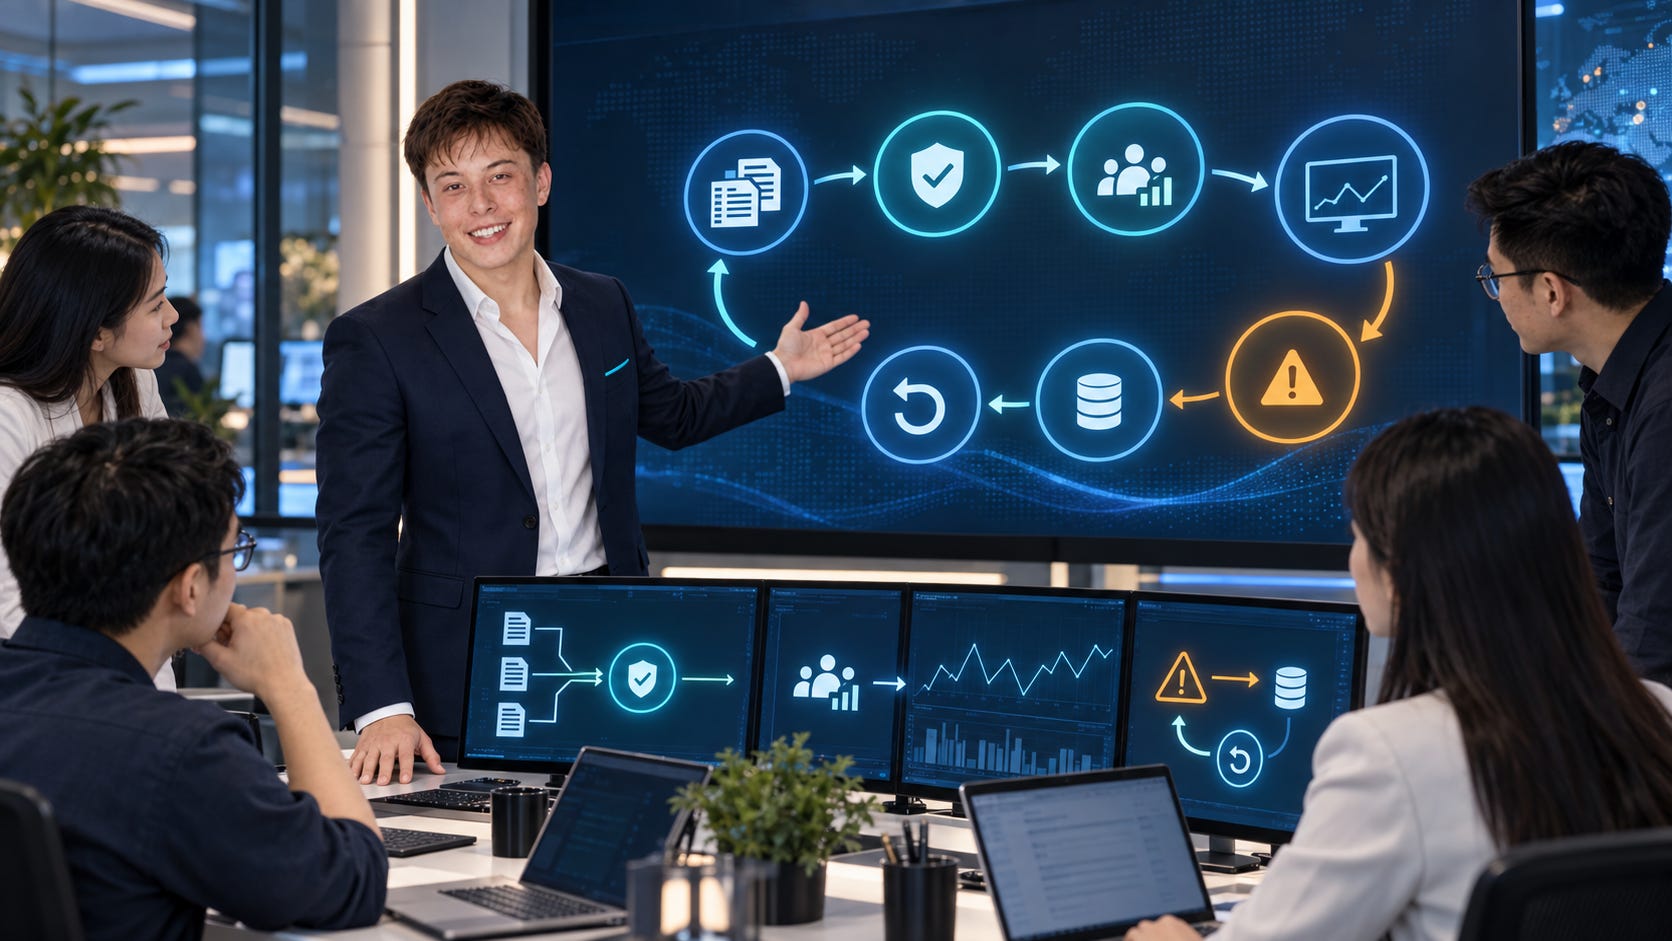
Một pipeline thực dụng có thể đi theo sáu bước:
Bước 1: Đóng băng danh tính hệ thống
Ghi lại model, prompt, dữ liệu, tool, policy, thông số inference, evaluator, test suite và commit code. Đây là “căn cước” của candidate release.
Bước 2: Chạy offline suites
Chạy các case đại diện, critical slices, adversarial và regression. Thu output, trace, latency, chi phí và kết quả của từng evaluator.
Bước 3: So với baseline đã được duyệt
Không chỉ hỏi candidate đạt bao nhiêu, mà hỏi nó thay đổi thế nào so với phiên bản đang chạy. Một cải thiện chung không được bù cho một critical slice mới bị hỏng.
Bước 4: Áp release gates
Gate nên được định nghĩa trước cuộc họp phát hành. Nếu đợi nhìn kết quả rồi mới đặt ngưỡng, đội rất dễ “giải thích” số liệu theo phiên bản mình muốn ship.
Một bộ gate có thể gồm:
hard blocker cho vi phạm chính sách nghiêm trọng;
quality gate cho các tác vụ lõi;
slice gate cho nhóm rủi ro cao;
reliability gate cho tool success và latency;
cost gate cho ngân sách mỗi tác vụ.
Bước 5: Canary có kiểm soát
Qua offline chưa có nghĩa là mở cho 100% người dùng. Bắt đầu bằng traffic nhỏ, giới hạn quyền hành động và theo dõi những tín hiệu thật: fallback, từ chối, lỗi tool, latency, khiếu nại, chi phí và sự can thiệp của con người.
Bước 6: Đóng vòng lặp
Mỗi sự cố mới cần được điều tra qua trace, chuyển thành regression case và gắn vào evaluator phù hợp. Nếu production chỉ tạo ticket rồi đóng lại, hệ thống đánh giá không học được gì.
Đây cũng là nơi context engineering trở thành nền móng vận hành: muốn tái hiện một lỗi, ta phải biết AI đã nhìn thấy dữ liệu, chỉ dẫn và trạng thái nào trong run đó.
Minimum Viable Evaluation System cho đội nhỏ
Bạn không cần mua một nền tảng lớn rồi mới bắt đầu. Một đội nhỏ có thể dựng phiên bản đầu bằng:
file YAML hoặc JSON lưu case và metadata;
một script chạy candidate trên bộ case;
validator cho schema, tool và policy cứng;
một rubric judge cho chất lượng mở;
trace được lưu cho case thất bại;
bảng báo cáo theo suite và slice;
checklist ghi quyết định ship, block hay review;
quy tắc biến incident thành regression test.
Khó nhất không phải công nghệ. Khó nhất là kỷ luật tổ chức.
Dashboard có thể màu xanh nhưng người có quyền vẫn bỏ qua gate. Test suite có thể rất lớn nhưng không ai cập nhật sau sự cố. Judge có thể tinh vi nhưng rubric không gắn với hậu quả kinh doanh. Những thứ đó tạo ra evaluation theater: rất nhiều điểm số, rất ít quyết định tốt hơn.
Một hệ thống đánh giá tối thiểu có giá trị khi trả lời được năm câu:
Chính xác cấu hình nào đang được đánh giá?
Những thất bại nào có thể gây hậu quả lớn?
Bằng chứng nào phát hiện từng loại thất bại?
Ngưỡng nào dẫn đến ship, block, review hoặc rollback?
Sự cố ngoài production quay lại bộ test bằng cách nào?
Nếu chưa trả lời được, đừng vội tranh luận model nào hơn 2 điểm benchmark.
Câu hỏi đúng không phải “AI thông minh đến đâu?”
Trong sản phẩm tạo sinh, nhiều câu trả lời khác nhau đều có thể đúng. Một lần chạy đẹp không chứng minh được độ ổn định. Một điểm trung bình cao không xóa được lỗi ở nhóm rủi ro. Một model mạnh không cứu được dữ liệu cũ, công cụ lỗi hay quyền hạn thiết kế sai.
Vì thế, câu hỏi trưởng thành hơn là:
Với cấu hình này, dưới những tình huống này, chúng ta có đủ bằng chứng để thực hiện hành động nào?
Minh cần câu hỏi đó để biết chatbot có đủ an toàn cho buổi demo hay chưa. Lan cần nó để bảo vệ khách hàng khỏi một lời hứa hoàn tiền không có thật. Doanh nghiệp cần nó để biến AI từ màn trình diễn thành một hệ thống có thể chịu trách nhiệm.
Đừng bắt đầu bằng một dashboard 50 metric.
Hãy bắt đầu bằng một tác vụ thật, mười đến hai mươi case có ý nghĩa, ba failure mode đáng sợ nhất, evaluator phù hợp cho từng lỗi và một gate mà cả đội cam kết sẽ tôn trọng.
Đánh giá tốt không làm AI hoàn hảo. Nó giúp con người biết khi nào có thể tin, khi nào phải kiểm tra và khi nào nhất định không được triển khai.