

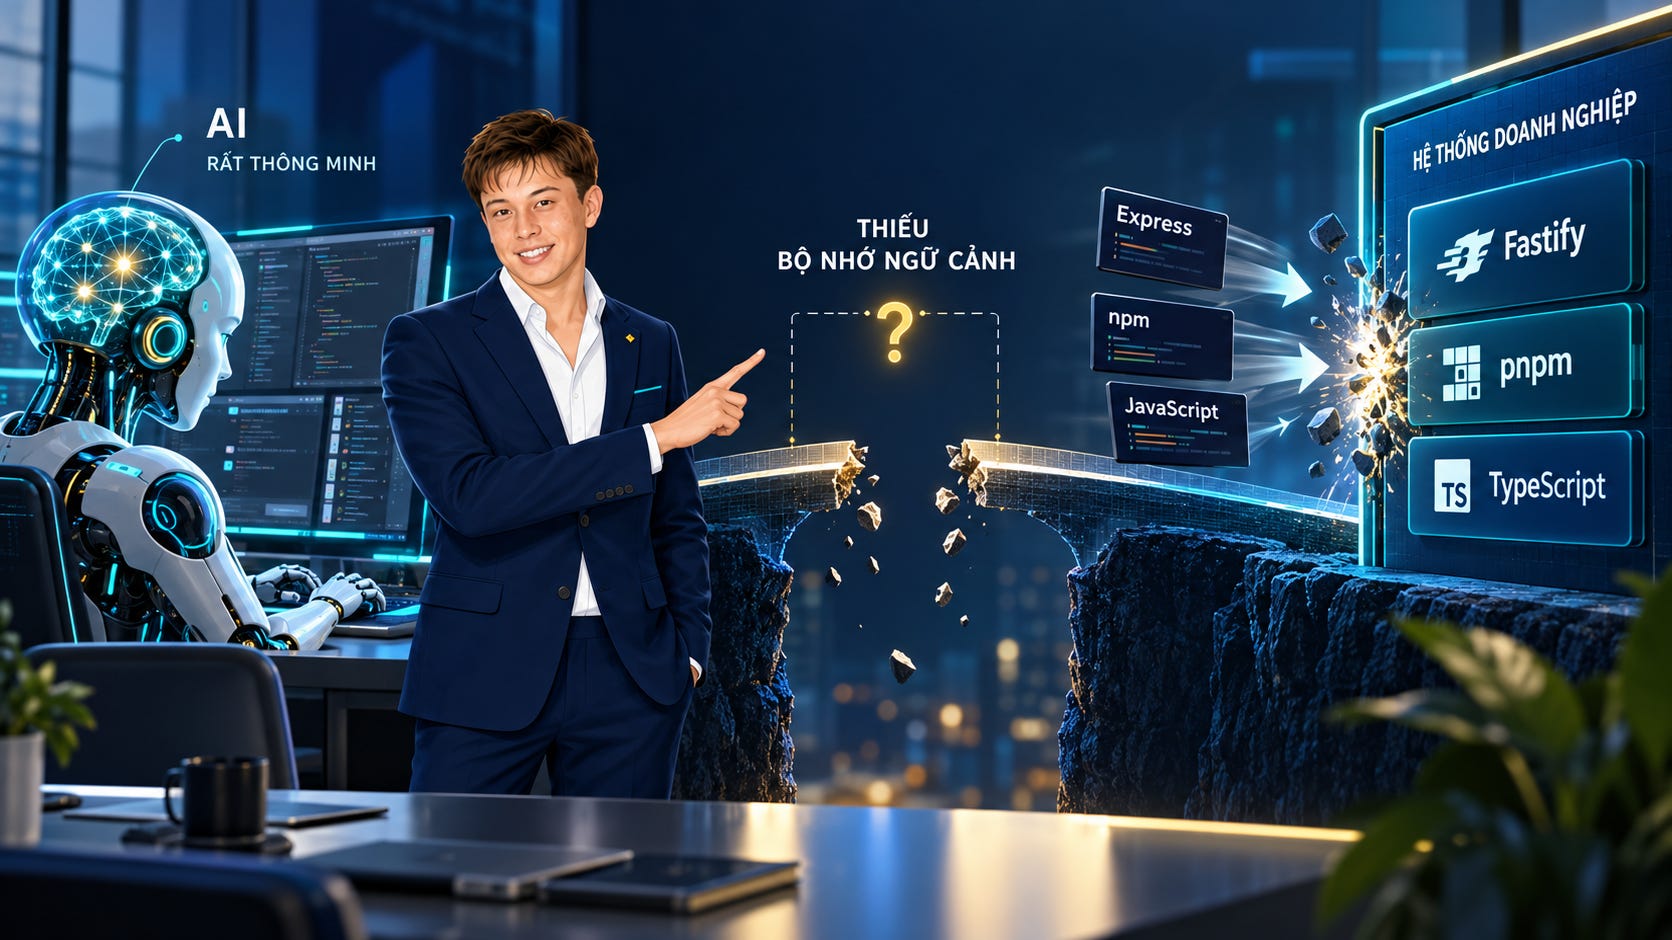
Bạn giao AI viết một API đăng nhập.
Nó trả về code khá đẹp. Có route, controller, model, thậm chí cả lệnh cài đặt.
Chỉ có ba vấn đề nhỏ:
Công ty dùng Fastify, nó chọn Express.
Team dùng TypeScript, nó viết JavaScript.
Quy trình bắt buộc dùng
pnpm, nó lại hướng dẫnnpm install.
Bạn sửa cho nó. AI hiểu. Hai bên làm việc trơn tru.
Sáng hôm sau, bạn mở một phiên mới.
Nó lại viết Express.
Đây là chỗ nhiều doanh nghiệp kết luận sai: “Model này chưa đủ thông minh.”
Không. Nó có thể rất giỏi. Thứ nó thiếu không phải năng lực, mà là ký ức về cách doanh nghiệp của bạn vận hành.
Và nếu không giải quyết tầng ký ức này, mua model mạnh hơn chỉ giúp AI… làm sai nhanh hơn.
Hãy hình dung AI là một nhân viên mới có một năm kinh nghiệm
Một nhân viên mới có một năm kinh nghiệm không phải người kém.
Họ biết viết code. Biết phân tích. Biết các thông lệ phổ biến của ngành. Khi thiếu thông tin, họ vẫn có thể đưa ra một phương án nghe rất hợp lý.
Nhưng họ chưa biết công ty bạn:
Vì sao team chọn Fastify thay vì Express.
Ai được quyền duyệt thay đổi cơ sở dữ liệu.
Khi nào phải hỏi lại khách hàng.
Một “lead chất lượng” được định nghĩa ra sao.
Báo cáo nào cần gửi vào sáng thứ Hai, theo mẫu nào.
Có những sai lầm nào team đã trả học phí rồi và không muốn lặp lại.
AI cũng vậy: hãy quản lý nó như một nhân viên mới, thay vì tuyển nó như một “nhà tiên tri”.
Mỗi cuộc trò chuyện mới giống như ngày đầu tiên nhân viên đó bước vào văn phòng. Nếu không có tài liệu onboarding, nó sẽ dùng kiến thức phổ thông để lấp chỗ trống.
Express phổ biến hơn Fastify? Chọn Express.
npm xuất hiện nhiều hơn pnpm? Chọn npm.
Không thấy quy định phê duyệt? Tự quyết theo cách có vẻ hợp lý nhất.
Đó không phải “ảo giác” theo nghĩa AI bịa ra mọi thứ. Nhiều khi nó đang đưa ra một đáp án hoàn toàn hợp lý — nhưng hợp lý với thế giới nói chung, không đúng với công ty của bạn.
Khác biệt này rất quan trọng. Vì nếu chẩn đoán sai là “AI yếu”, bạn sẽ đổi model. Nếu chẩn đoán đúng là “AI thiếu bối cảnh”, bạn sẽ sửa hệ thống.
Hoặc coi AI như một sinh viên năm ba
Một sinh viên năm ba ngành công nghệ có thể biết thuật toán, cơ sở dữ liệu, framework và cách đọc tài liệu.
Giao một bài tập độc lập, bạn ấy có thể làm rất tốt.
Nhưng đưa vào một hệ thống đang chạy thật, nơi có khách hàng thật, dữ liệu thật và những quyết định kiến trúc tích lũy nhiều năm, chuyện khác hẳn.
Bạn ấy không thể tự biết:
Quy tắc nào là “best practice” chung.
Quy tắc nào là lựa chọn riêng của công ty.
Quy tắc nào là ranh giới an toàn không được phép vượt qua.
Quy tắc nào chỉ áp dụng cho một loại công việc cụ thể.
Nếu người quản lý chỉ nói: “Em cứ chủ động nhé”, sai sót gần như chắc chắn xảy ra.
Với AI, chúng ta lại thường làm đúng như vậy. Một câu lệnh rất rộng, quyền truy cập rất lớn, rồi hy vọng model tự hiểu toàn bộ lịch sử của tổ chức.
Nó không thể hiểu thứ chưa từng được cung cấp.
Bộ nhớ AI không phải một file dài 100 trang
Khi nghe đến “xây bộ nhớ cho AI”, phản xạ đầu tiên của nhiều team là gom tất cả vào một tài liệu khổng lồ.
Sơ đồ tổ chức. Brand guideline. Hướng dẫn kỹ thuật. Biên bản họp. Quy trình nhân sự. Danh sách công cụ. Tất cả nhét vào một file rồi bắt AI đọc trước khi làm việc.
Kết quả thường tệ hơn.
Context window không phải nhà kho vô hạn. Nó giống mặt bàn làm việc. Đặt càng nhiều giấy lên bàn, tài liệu quan trọng càng dễ bị chôn.
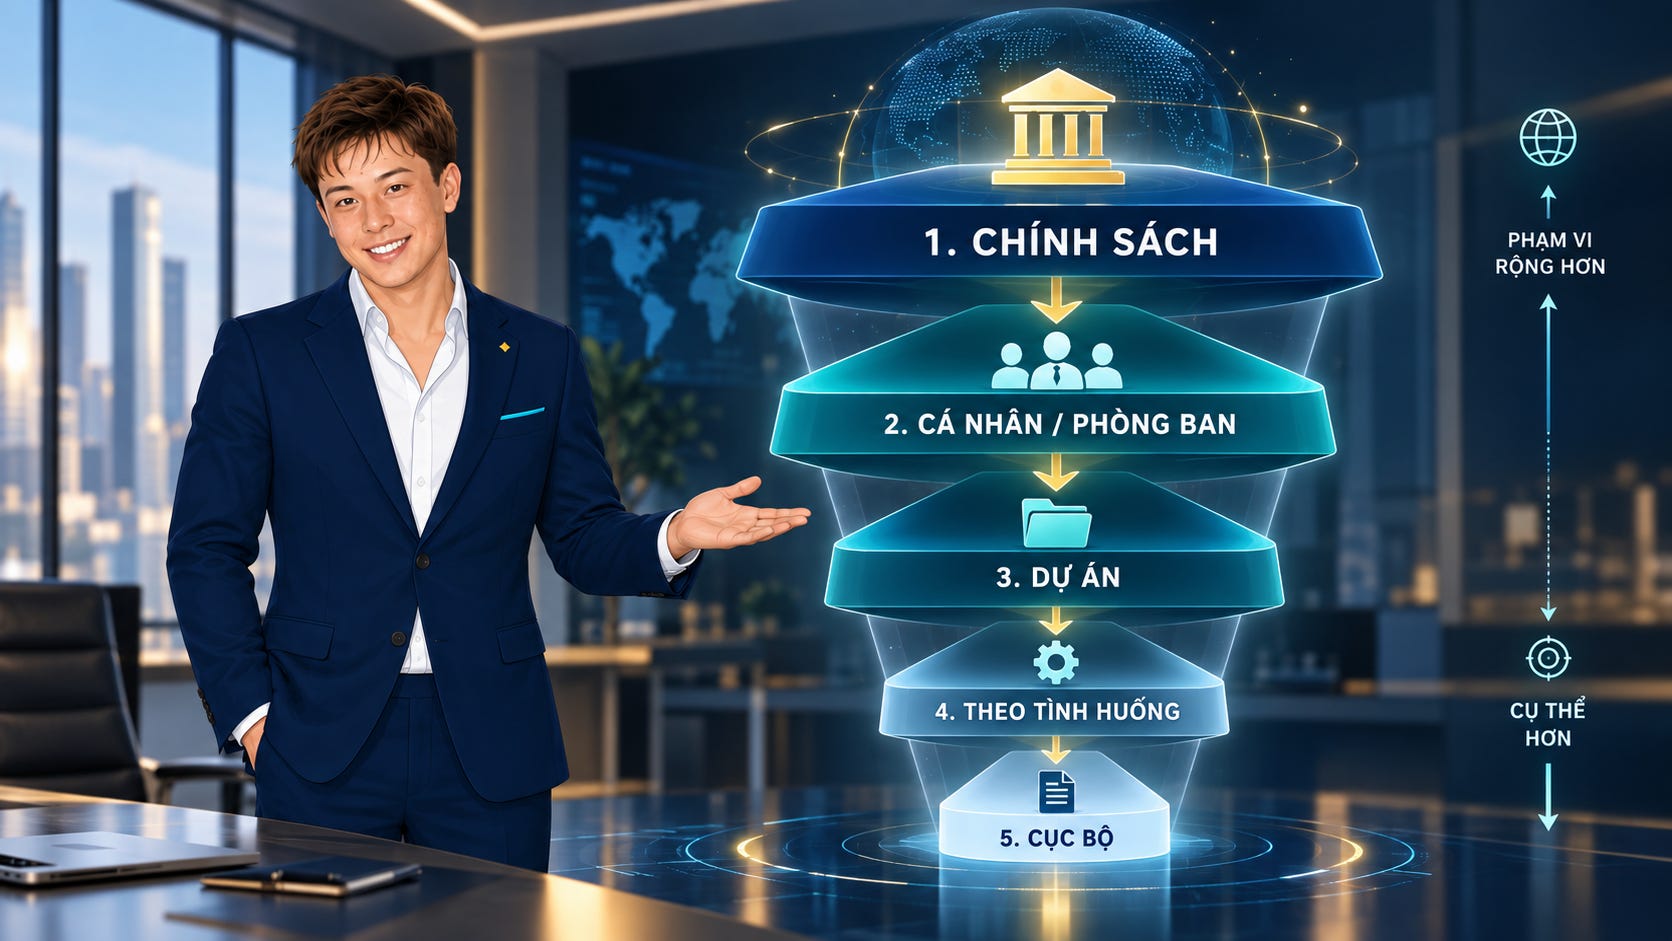
Một bộ nhớ tốt cần được chia theo phạm vi và mức độ ưu tiên.
Tầng 1: Chính sách doanh nghiệp
Đây là các ranh giới không được thương lượng:
Không gửi dữ liệu khách hàng sang dịch vụ bên ngoài chưa được duyệt.
Không ghi secret trực tiếp vào code.
Mọi thay đổi dữ liệu sản xuất phải có phê duyệt.
Các quyết định tài chính vượt ngưỡng phải chuyển cho con người.
Tầng này giống quy định an toàn của cả tập đoàn. Dự án hay cá nhân không được tự ý ghi đè.
Tầng 2: Cách làm việc của cá nhân hoặc phòng ban
Đây là những ưu tiên ổn định nhưng không nhất thiết áp dụng cho toàn công ty:
Trả lời bằng tiếng Việt, chú thích code bằng tiếng Anh.
Báo cáo luôn mở đầu bằng ba kết luận chính.
Commit message theo một định dạng thống nhất.
Khi được yêu cầu “chạy kiểm thử”, dùng đúng bộ lệnh của team.
Tầng 3: Bộ nhớ của dự án
Đây là phần AI cần để không đoán mò:
Công nghệ đang dùng và công nghệ bị cấm.
Cấu trúc thư mục.
Luồng phụ thuộc giữa các lớp.
Định nghĩa đầu vào, đầu ra.
Các lệnh thường dùng.
Tiêu chí để xác nhận một việc đã hoàn thành.
Với một dự án phần mềm dùng Claude Code, tài liệu này có thể là CLAUDE.md. Với một agent chăm sóc khách hàng, nó có thể là bộ hướng dẫn vận hành cùng dữ liệu sản phẩm đã được kiểm soát.
Tên file không quan trọng bằng vai trò: biến tri thức ngầm thành chỉ dẫn máy có thể đọc và hành động.
Tầng 4: Quy tắc theo tình huống
AI chỉ nên tải quy tắc kiểm thử khi viết test. Chỉ tải quy định cơ sở dữ liệu khi đụng tới migration. Chỉ tải tone of voice khi tạo nội dung.
Đây là nguyên tắc “đúng thông tin, đúng thời điểm”.
Nếu nhân viên lễ tân phải học thuộc cả quy trình vận hành kho trước khi nghe điện thoại, đó không phải đào tạo kỹ. Đó là gây nhiễu.
Tầng 5: Ghi chú cục bộ
Đây là những thông tin tạm thời hoặc riêng tư:
Môi trường thử nghiệm hôm nay đang lỗi.
Một endpoint cũ chưa thể bỏ vì còn khách hàng sử dụng.
Mẹo debug trên máy cá nhân.
Công việc đang dở và giả thuyết cần kiểm tra tiếp.
Không phải ký ức nào cũng đáng đưa thành luật chung.
Viết bộ nhớ theo ba câu hỏi: Tại sao, cái gì, làm thế nào
Một tài liệu AI hiệu quả không cần dài. Nó cần trả lời ba câu hỏi theo đúng thứ tự.
1. Tại sao?
Cho AI biết mục tiêu kinh doanh hoặc rủi ro đứng sau quy tắc.
Thay vì:
Không được gọi trực tiếp database từ controller.
Hãy thêm lý do ngắn:
Mọi truy vấn phải đi qua repository để giữ logic dữ liệu ở một nơi và có thể kiểm thử. Controller không được gọi database trực tiếp.
Khi gặp tình huống chưa được viết sẵn, AI có nguyên tắc để suy luận thay vì chỉ học thuộc câu chữ.
2. Cái gì?
Nói rõ việc phải làm và việc không được làm.
Ví dụ:
Dùng Fastify 4 và TypeScript.
Không dùng Express.
Dùng
pnpm.Không tạo thêm package manager lockfile.
Mọi input API phải được kiểm tra bằng Zod.
“Hãy viết code chất lượng cao” không phải quy tắc. Không ai biết “cao” là gì.
3. Làm thế nào?
Đưa quy trình có thể thực thi:
Đọc file cấu hình liên quan.
Tìm module tương tự đang hoạt động.
Thực hiện thay đổi nhỏ nhất.
Chạy lint và test.
Nêu bằng chứng đã kiểm tra trước khi báo hoàn thành.
AI làm tốt nhất khi “xong” có định nghĩa rõ ràng.
Bài kiểm tra đơn giản: Xóa dòng này thì AI sẽ sai gì?
Đây là cách mình lọc một tài liệu bộ nhớ.
Với từng dòng, hỏi:
Nếu xóa dòng này, AI có khả năng mắc lỗi cụ thể nào?
Nếu không trả lời được, dòng đó có thể không cần nằm trong bộ nhớ luôn bật.
Ví dụ:
“Dự án coi trọng chất lượng” — xóa đi gần như không thay đổi hành vi.
“Danh sách API phải có
page,limit;limittối đa 100” — xóa đi, AI có thể tạo pagination khác chuẩn.“Hãy suy nghĩ cẩn thận” — không tạo ra tiêu chí kiểm tra.
“Không sửa migration đã lên nhánh chính; luôn tạo migration mới” — ngăn một lỗi vận hành cụ thể.
Một bộ nhớ 30 dòng có sức nặng thường tốt hơn 300 dòng khẩu hiệu.
Khi nào dùng luật chung, khi nào dùng luật theo đường dẫn?
Giả sử dự án có frontend, backend, dữ liệu và hạ tầng.
Nếu mọi phiên làm việc đều phải tải toàn bộ quy định, một người đang sửa nút bấm cũng phải mang theo hướng dẫn migration database, CI/CD và cách huấn luyện model.
Cách tốt hơn là tách bộ nhớ:
Phạm vi
Nội dung nên đặt
Khi tải
Toàn dự án
Mục tiêu, stack, ranh giới bảo mật, lệnh chính
Mọi phiên
Frontend
Component, state, accessibility
Khi sửa file frontend
Backend
API, layer, error format
Khi sửa route/service
Database
Transaction, migration, repository
Khi sửa schema/data
Testing
Framework, mock, coverage
Khi viết test
Trong Claude Code, các rule có thể được gắn với mẫu đường dẫn. Tư duy này cũng áp dụng cho hệ thống agent nói chung: đừng nạp mọi tri thức vào mọi tác vụ; hãy truy xuất phần liên quan khi cần.
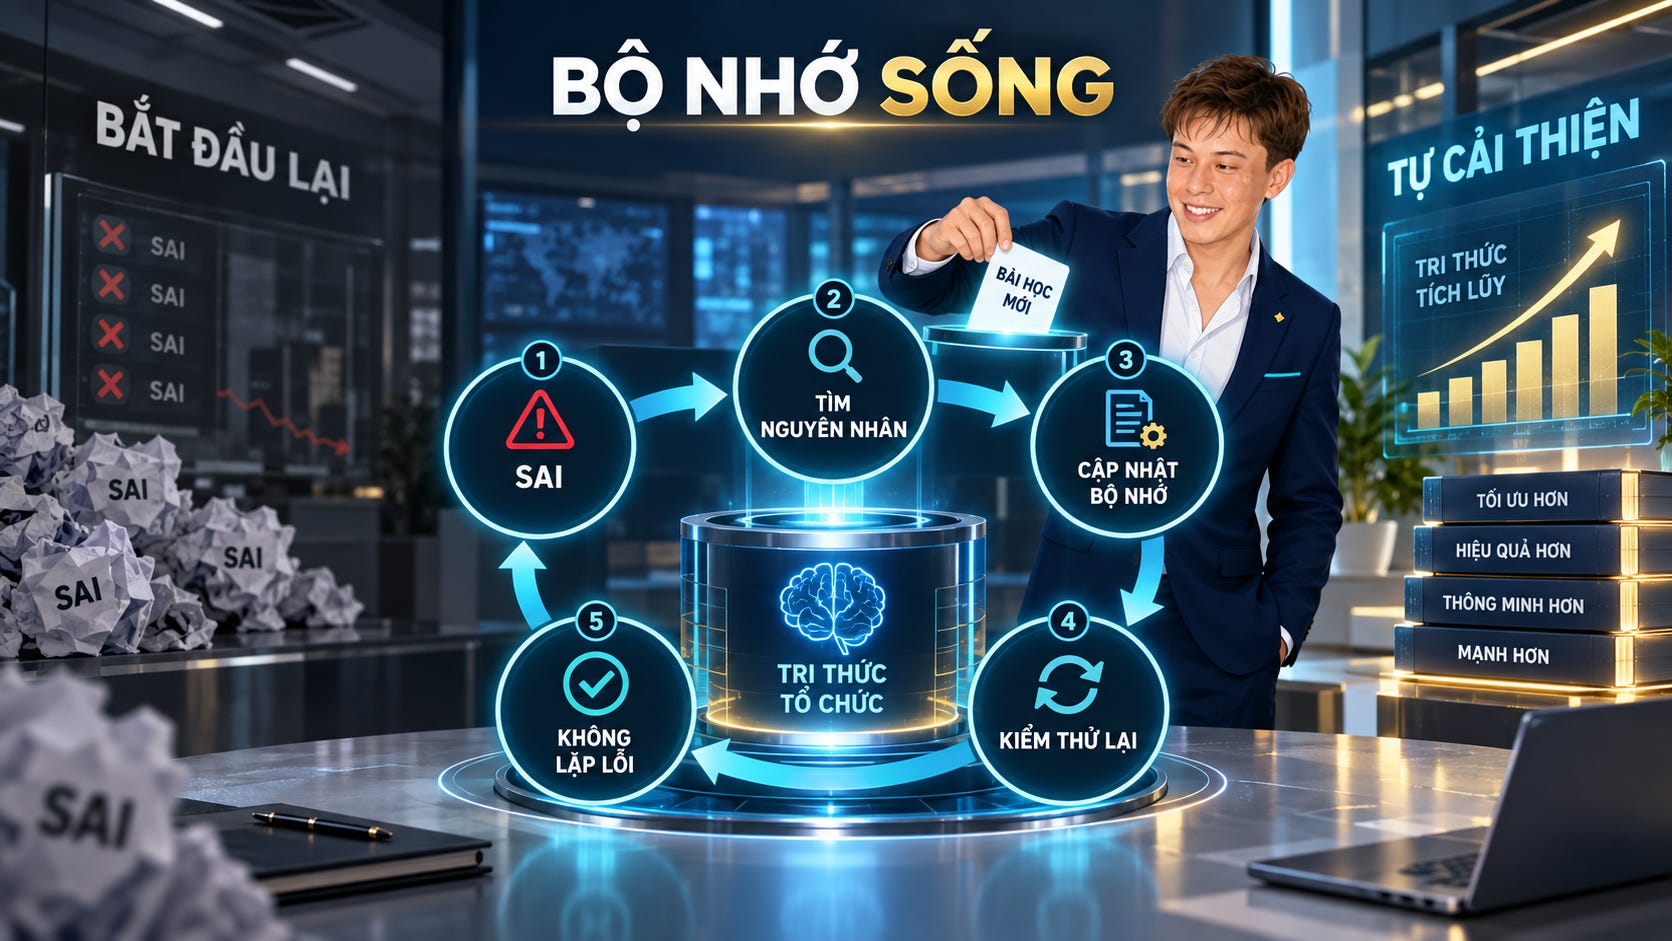
Bộ nhớ chỉ có giá trị nếu nó sống
Tài liệu onboarding viết một lần rồi bỏ quên sẽ nhanh chóng trở thành nguồn gây lỗi mới.
Quy trình tốt phải có vòng lặp:
Sai → tìm nguyên nhân → cập nhật bộ nhớ → kiểm thử lại → tránh lặp lại.
Ví dụ AI dùng nhầm thư viện ngày tháng.
Đừng chỉ sửa output lần đó. Hãy hỏi:
Đây là lỗi tình cờ hay lỗi có thể lặp lại?
Quy tắc đúng áp dụng toàn dự án hay chỉ một module?
Nên thêm vào bộ nhớ chung hay rule theo tình huống?
Có thể viết bài kiểm tra tự động để chặn lỗi không?
Nếu câu trả lời là “có thể lặp lại”, lần sửa đó nên để lại tài sản cho hệ thống.
Đây mới là chỗ AI giúp doanh nghiệp tạo lợi thế. Không phải vì model của bạn khác model đối thủ. Mà vì mỗi thất bại làm bộ nhớ vận hành của bạn tốt lên, trong khi đối thủ vẫn bắt đầu lại từ đầu ở từng cuộc chat.
Đừng nhầm bộ nhớ với kiểm soát
Một lưu ý quan trọng: tài liệu hướng dẫn không phải hàng rào kỹ thuật.
Bạn có thể viết “không được xóa dữ liệu”, nhưng nếu agent vẫn có quyền xóa cơ sở dữ liệu sản xuất, rủi ro vẫn còn. Vì thế, đánh giá AI phải dẫn đến quyết định triển khai, chặn hoặc quay lui, chứ không chỉ tạo ra một con số đẹp trên dashboard.
Bộ nhớ giúp AI biết nên làm gì. Cơ chế quyền hạn, phê duyệt, sandbox, test và giám sát mới quyết định AI được phép làm gì.
Doanh nghiệp cần cả hai:
Bộ nhớ để giảm quyết định sai do thiếu bối cảnh.
Guardrail để giới hạn thiệt hại nếu quyết định vẫn sai.
Đừng dùng một file Markdown thay cho kiến trúc an toàn.
Bắt đầu trong 30 phút
Không cần xây knowledge base khổng lồ.
Chọn một workflow AI đang làm sai lặp đi lặp lại, rồi viết một trang ngắn:
Mục tiêu: Workflow này tạo ra kết quả gì?
Đầu vào: AI được dùng dữ liệu nào?
Đầu ra: Mẫu kết quả chuẩn trông ra sao?
Quy tắc bắt buộc: 5–10 điều không được đoán.
Điều cấm: Những hành động hoặc công cụ không được dùng.
Quy trình kiểm tra: AI phải chứng minh điều gì trước khi báo xong?
Điểm chuyển người: Khi nào AI phải dừng và hỏi?
Sau đó chạy lại một tác vụ thật.
Đừng đánh giá bằng câu “trông có vẻ hay”. Hãy đo:
Số lần phải sửa.
Loại lỗi bị lặp lại.
Thời gian từ yêu cầu đến kết quả dùng được.
Tỷ lệ việc cần con người can thiệp.
Chi phí context và công cụ.
Nếu AI vẫn sai, đừng vội thêm mười trang tài liệu. Tìm đúng một mẩu bối cảnh đang thiếu.
Câu hỏi cuối cùng
AI của bạn đang làm sai vì nó chưa đủ thông minh?
Hay vì mỗi sáng bạn lại đưa một “nhân viên mới” vào công ty, không onboarding, không quy trình, không ký ức — rồi ngạc nhiên khi họ dùng cách làm của nơi khác?
Model là năng lực.
Context là hiểu biết hiện tại.
Bộ nhớ là khả năng không phải trả học phí hai lần cho cùng một sai lầm.
Trong triển khai AI doanh nghiệp, thứ ba thường ít hào nhoáng nhất.
Nhưng cũng là thứ tạo ra khoảng cách bền nhất.