

Một khung ra quyết định thực dụng để chọn, triển khai và vận hành mô hình ngôn ngữ cho AI Agent trong doanh nghiệp.
Nhiều dự án AI Agent bắt đầu bằng một câu hỏi nghe có vẻ hợp lý: “Mô hình nào đang mạnh nhất?”
Nhưng đó thường là câu hỏi sai.
Một mô hình dẫn đầu bảng xếp hạng vẫn có thể là lựa chọn tệ nếu phản hồi quá chậm, chi phí mỗi tác vụ quá cao, gọi sai công cụ, không đáp ứng yêu cầu dữ liệu, hoặc suy giảm chất lượng khi quy trình kéo dài qua nhiều bước. Với AI Agent, doanh nghiệp không chỉ mua khả năng sinh văn bản. Doanh nghiệp đang giao cho một mô hình quyền hiểu tình huống, lập kế hoạch, chọn hành động và kích hoạt hệ thống thật.
Vì thế, “agent-ready” không phải là một nhãn dán trên model card. Đó là mức độ phù hợp giữa mô hình với nhiệm vụ, kiến trúc, cơ chế kiểm soát và điều kiện vận hành của doanh nghiệp.
LLM là bộ não, nhưng Agent cần cả một hệ thần kinh
Trong chatbot thông thường, LLM chủ yếu nhận câu hỏi rồi tạo câu trả lời. Trong một Agent, vai trò ấy rộng hơn nhiều:
Cảm nhận và diễn giải: hiểu yêu cầu, tài liệu, dữ liệu hoặc tín hiệu từ môi trường.
Suy luận và lập kế hoạch: chia mục tiêu thành các bước có thể thực hiện.
Điều phối công cụ: chọn API, cơ sở dữ liệu hay hệ thống nghiệp vụ phù hợp; tạo đúng tham số; đọc kết quả trả về.
Duy trì ngữ cảnh: kết nối thông tin từ các bước trước với quyết định hiện tại.
Giao tiếp: giải thích quyết định, yêu cầu bổ sung dữ liệu hoặc chuyển giao cho con người.
Một quy trình xét duyệt hồ sơ vay là ví dụ dễ hình dung. Agent không chỉ “đọc hồ sơ”. Nó có thể phải kiểm tra tính đầy đủ của tài liệu, trích xuất dữ liệu, gọi dịch vụ chấm điểm tín dụng, kiểm tra gian lận, đối chiếu chính sách và lập bản tóm tắt cho chuyên viên thẩm định. Mỗi bước tạo ra một quan sát mới; quan sát ấy lại ảnh hưởng đến quyết định tiếp theo.
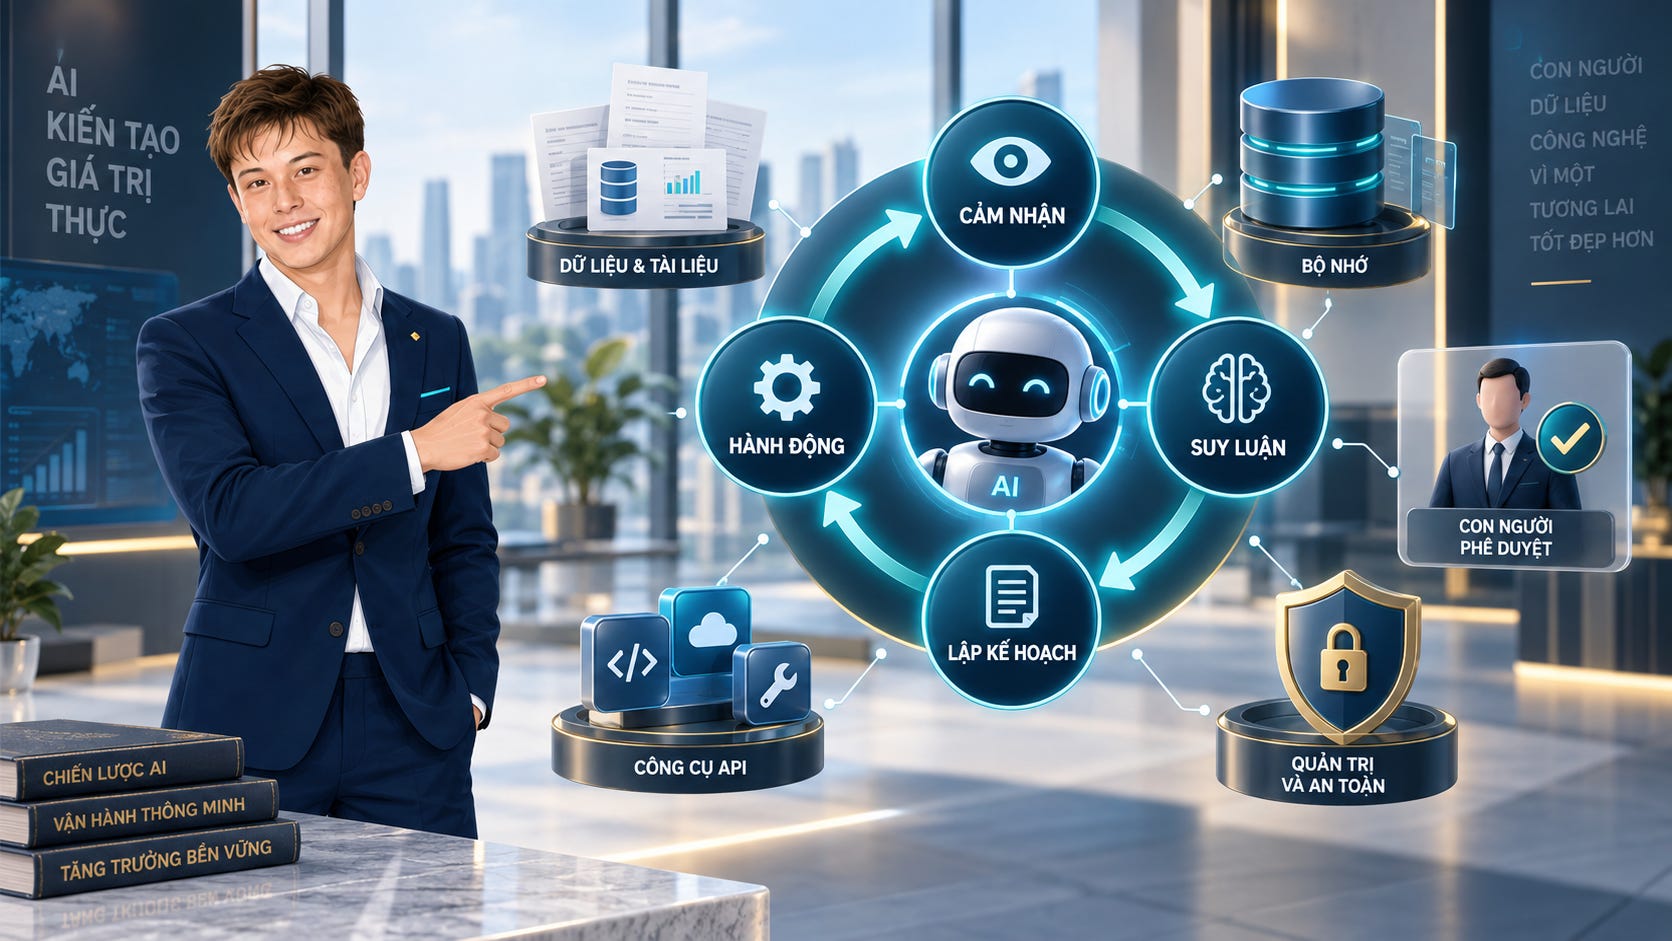
Điểm quan trọng là: LLM chỉ là lõi suy luận. Chất lượng của Agent còn phụ thuộc vào bộ nhớ, dữ liệu, công cụ, lớp phân quyền, cơ chế xác thực, khả năng quan sát và điểm dừng để con người can thiệp. Một “bộ não” rất mạnh nối với công cụ thiếu kiểm soát vẫn tạo ra một hệ thống nguy hiểm. Ngược lại, một mô hình vừa đủ, đặt trong kiến trúc tốt, có thể tạo ra giá trị ổn định hơn nhiều. Đây cũng là lý do prompt hay chưa đủ nếu AI không có một “bàn làm việc” được thiết kế đúng.
Bảy câu hỏi quan trọng hơn bảng xếp hạng
Thay vì so sánh model bằng một con số tổng hợp, đội dự án nên đánh giá theo bảy chiều gắn trực tiếp với workload.
1. Agent thực sự phải giải quyết việc gì?
Hãy mô tả tác vụ ở mức hành động, không dừng ở một nhãn rộng như “trợ lý chăm sóc khách hàng”.
Agent có cần:
tổng hợp nhiều tài liệu dài;
xử lý yêu cầu mơ hồ;
suy luận qua nhiều bước;
lựa chọn trong hàng chục công cụ;
sinh JSON đúng schema;
thực hiện thao tác có rủi ro tài chính;
hay chỉ phân loại và chuyển tiếp yêu cầu?
Một Agent nghiên cứu thị trường cần tổng hợp đa nguồn sẽ ưu tiên khả năng suy luận và ngữ cảnh dài. Một Agent định tuyến ticket có thể ưu tiên tốc độ, độ ổn định và chi phí thấp. Gọi cả hai là “AI Agent” không có nghĩa chúng cần cùng một mô hình.
2. Cửa sổ ngữ cảnh lớn đến đâu là đủ?
Context window lớn hữu ích khi Agent phải đọc hợp đồng dài, theo dõi hội thoại nhiều vòng hoặc giữ thông tin xuyên suốt một quy trình phức tạp. Nhưng con số tối đa do nhà cung cấp công bố không đồng nghĩa với khả năng sử dụng hiệu quả toàn bộ ngữ cảnh.
Ba câu hỏi thực tế cần kiểm tra:
Mô hình có tìm đúng chi tiết quan trọng khi thông tin nằm giữa một ngữ cảnh rất dài không?
Chất lượng suy luận có giảm khi khối lượng đầu vào tăng không?
Độ trễ và chi phí tăng bao nhiêu cho mỗi tác vụ?
Đừng trả tiền cho một triệu token nếu luồng việc chỉ cần 20.000 token. Và cũng đừng giả định rằng có context lớn thì không cần kiến trúc dữ liệu. Tóm tắt, truy xuất có chọn lọc và quản trị bộ nhớ vẫn cần thiết để Agent không bị “ngập” trong dữ liệu không liên quan.
3. Mô hình có gọi công cụ đáng tin cậy không?
Đây là tiêu chí mang tính sống còn. Một Agent chỉ thật sự tạo ra hành động khi LLM có thể:
nhận biết đúng lúc cần gọi công cụ;
chọn đúng công cụ trong danh mục;
tạo tham số đúng schema;
xử lý lỗi hoặc dữ liệu thiếu;
đọc kết quả và quyết định bước kế tiếp;
biết khi nào phải dừng hoặc chuyển cho con người.
Với nghiệp vụ có rủi ro cao, “gần đúng” là chưa đủ. Một trường JSON sai kiểu dữ liệu có thể làm hỏng cả quy trình. Một lần chọn nhầm API có thể tạo giao dịch ngoài ý muốn. Vì vậy, hãy benchmark bằng tool set thật và tình huống lỗi thật, thay vì chỉ thử vài prompt đẹp trong bản demo. Cách đánh giá này gần với tư duy đừng chấm AI bằng một bài thi cuối kỳ: kiểm tra phải diễn ra qua nhiều cổng của vòng đời hệ thống.
4. Mức độ ổn định và an toàn có phù hợp không?
Doanh nghiệp cần đo không chỉ câu trả lời đúng, mà cả tính nhất quán qua nhiều lần chạy. Các tình huống kiểm thử nên bao gồm:
yêu cầu thiếu dữ liệu;
chỉ dẫn mâu thuẫn;
prompt injection nằm trong tài liệu;
công cụ trả về lỗi hoặc timeout;
dữ liệu chứa thông tin nhạy cảm;
yêu cầu vượt quyền hạn của người dùng;
trường hợp cần từ chối hoặc chuyển cấp.
Độ tin cậy của Agent là thuộc tính của toàn hệ thống. LLM cần được bao quanh bởi validation, kiểm soát truy cập, allowlist công cụ, giới hạn hành động, nhật ký và phê duyệt của con người tại các điểm rủi ro.
5. Độ trễ và thông lượng nào chấp nhận được?
Một lần gọi model chậm hai giây có vẻ không đáng kể. Nhưng nếu Agent phải suy luận qua tám bước, gọi ba công cụ và tự kiểm tra kết quả, thời gian chờ sẽ cộng dồn rất nhanh.
Cần đo độ trễ đầu-cuối của cả tác vụ, không chỉ thời gian phản hồi của một lần inference. Với luồng tương tác trực tiếp, tốc độ phản hồi đầu tiên và tổng thời gian hoàn tất đều quan trọng. Với tác vụ nền, thông lượng và khả năng gom lô có thể quan trọng hơn.
6. Chi phí trên một kết quả kinh doanh là bao nhiêu?
Giá trên một triệu token không phản ánh đầy đủ tổng chi phí. Một mô hình rẻ nhưng thường xuyên làm sai, phải thử lại hoặc cần con người sửa nhiều có thể đắt hơn mô hình cao cấp.
Nên tính:
Chi phí mỗi tác vụ thành công = inference + hạ tầng + công cụ + retry + giám sát + xử lý thủ công
Đơn vị tối ưu không phải token. Đó có thể là một hồ sơ được xử lý đúng, một ticket được giải quyết, một báo cáo được hoàn tất hoặc một giờ lao động được tiết kiệm.
7. Mô hình có thể thích nghi và được quản trị lâu dài không?
Khả năng thích nghi có nhiều tầng: thiết kế prompt, in-context learning, RAG, fine-tuning hoặc distillation. Không phải bài toán nào cũng cần tinh chỉnh mô hình. Nhiều trường hợp, dữ liệu tốt hơn, công cụ rõ hơn và schema chặt hơn đem lại hiệu quả nhanh hơn fine-tuning.
Đồng thời, hãy xem xét giấy phép, khả năng triển khai, quyền riêng tư dữ liệu, năng lực đội ngũ, hỗ trợ của nhà cung cấp và khả năng thay thế model. Một kiến trúc khóa chặt vào một API duy nhất có thể giúp ra mắt nhanh, nhưng làm tăng chi phí chuyển đổi về sau.
Một mô hình lớn hay một đội hình nhiều mô hình?
Tư duy “một model cho mọi việc” thuận tiện ở giai đoạn thử nghiệm, nhưng hiếm khi tối ưu khi mở rộng.
Doanh nghiệp có thể dùng một mô hình mạnh làm orchestrator cho các nhiệm vụ cần lập kế hoạch và xử lý mơ hồ; sau đó chuyển các việc rõ ràng cho mô hình nhỏ hơn hoặc công cụ chuyên dụng. Ví dụ:
mô hình lớn phân tích mục tiêu và lập kế hoạch;
mô hình nhỏ phân loại tài liệu;
OCR trích xuất dữ liệu;
rule engine kiểm tra điều kiện bắt buộc;
dịch vụ chuyên biệt phát hiện gian lận;
con người phê duyệt quyết định có tác động lớn.
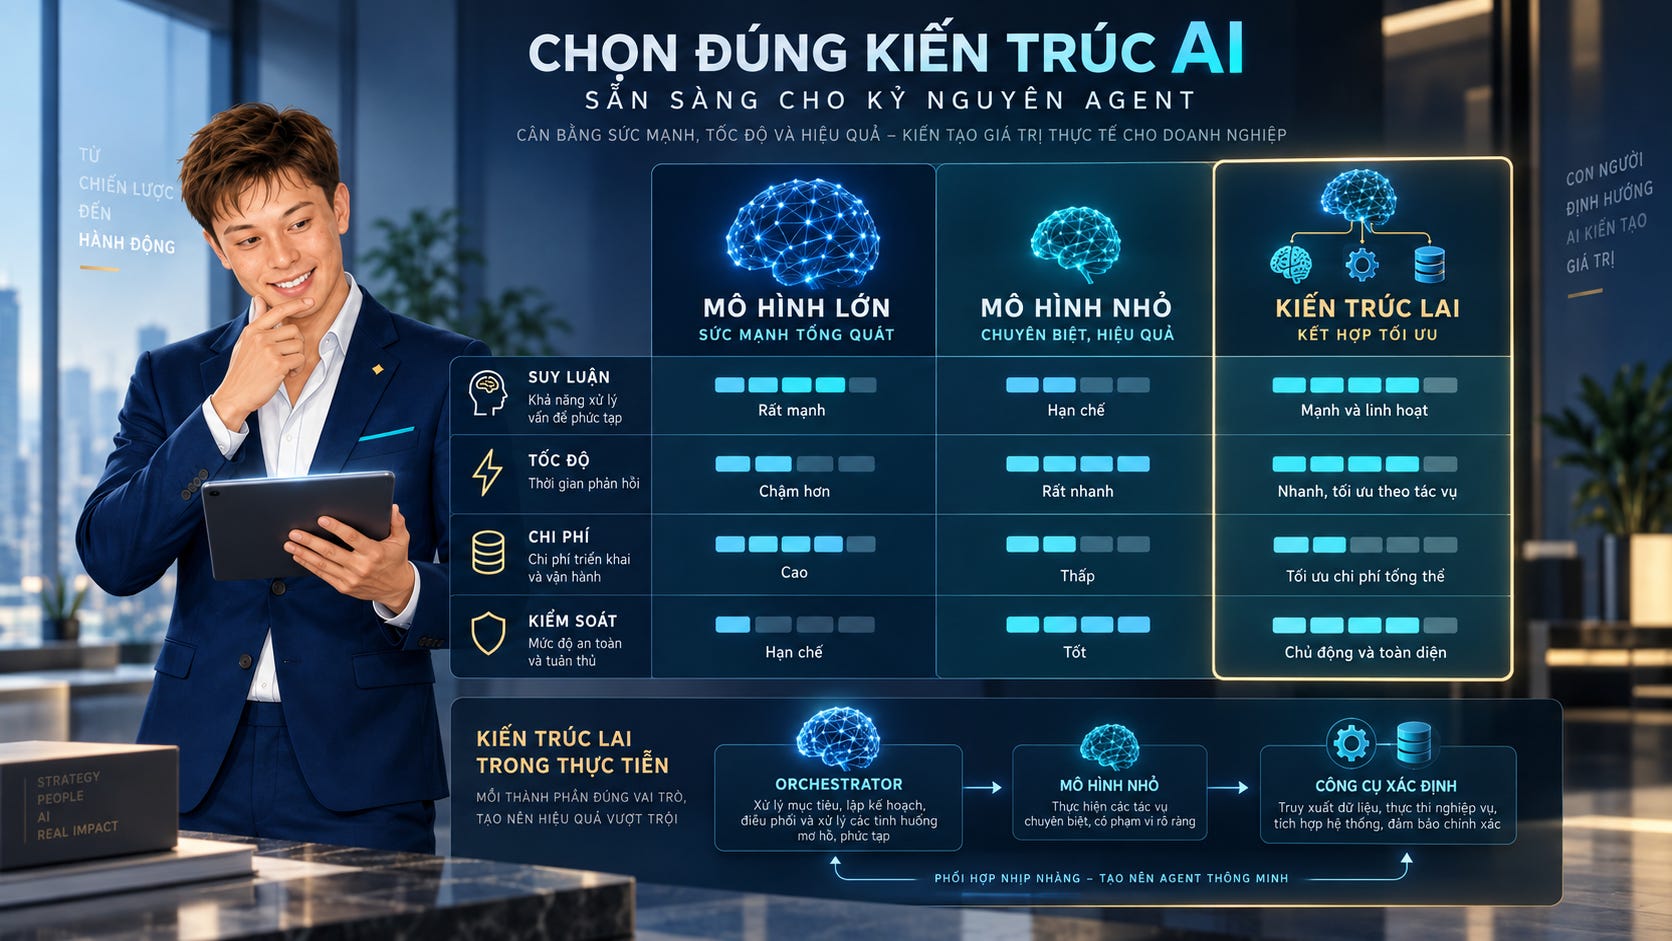
Kiến trúc lai đem lại ba lợi ích: giảm chi phí, rút ngắn độ trễ và thu hẹp phạm vi sai sót. Tuy nhiên, nó cũng tạo thêm độ phức tạp trong routing, quan sát và đánh giá. Chỉ nên chia nhỏ khi mỗi thành phần có ranh giới trách nhiệm rõ và lợi ích đo được.
Một nguyên tắc hữu ích là:
Dùng mô hình mạnh cho phần bất định; dùng mô hình nhỏ, quy tắc hoặc phần mềm truyền thống cho phần đã xác định.
Nếu quy trình luôn áp dụng một công thức cố định, đừng bắt LLM “suy nghĩ” lại công thức ở mỗi lần chạy. Nếu một quyết định có thể được kiểm tra bằng rule engine, hãy để rule engine làm việc đó.
Cloud API, self-hosted hay edge?
Lựa chọn mô hình không thể tách khỏi lựa chọn cách triển khai.
Phương án
Phù hợp khi
Đánh đổi chính
Cloud-hosted API
Cần ra mắt nhanh, tiếp cận model mạnh, ít năng lực vận hành hạ tầng
Phụ thuộc nhà cung cấp, chi phí biến đổi, yêu cầu quản trị dữ liệu và độ trễ mạng
Self-hosted
Cần kiểm soát dữ liệu, tùy biến sâu, workload đủ lớn và ổn định
Đầu tư GPU, đội ngũ MLOps/LLMOps, cập nhật và tối ưu inference
Edge/on-device
Cần phản hồi nhanh, hoạt động offline, dữ liệu không rời thiết bị
Hạn chế tài nguyên, thường phải dùng model nhỏ và quantization
Không có phương án “đúng” cho mọi tổ chức. Một ngân hàng có thể self-host cho dữ liệu nhạy cảm nhưng dùng cloud API cho nội dung công khai. Một nhà máy có thể chạy model nhỏ ở edge để phản ứng tức thời, đồng thời gửi tác vụ phân tích phức tạp lên hạ tầng trung tâm.
Điều quan trọng là thiết kế đường biên dữ liệu và quyền hành động trước khi chọn nền tảng.
Từ POC đến vận hành: AgentOps là phần không thể thiếu
POC thường được thử trên tập dữ liệu sạch, với người dùng thiện chí và số lượng yêu cầu nhỏ. Production thì ngược lại: dữ liệu bẩn, yêu cầu bất thường, tích hợp thay đổi, chi phí tăng và lỗi hiếm bắt đầu xuất hiện. Khi đó, doanh nghiệp cần đánh giá AI bằng quyết định triển khai, chặn hay quay lui, thay vì chỉ theo dõi một điểm benchmark đẹp.
AgentOps mở rộng tư duy vận hành mô hình sang toàn bộ hành vi của Agent. Một vòng đời tối thiểu nên gồm sáu bước:
Định nghĩa: mô tả nhiệm vụ, ngưỡng chất lượng, quyền hạn và điều kiện chuyển cho con người.
Benchmark: xây bộ tình huống đại diện, gồm cả ca bình thường, ca biên và ca tấn công.
Triển khai có giới hạn: bắt đầu với phạm vi hẹp, quyền thấp và người giám sát.
Quan sát: theo dõi prompt, phiên bản model, tool call, lỗi, độ trễ, chi phí và kết quả cuối.
Đánh giá liên tục: phát hiện drift, regression và thay đổi hành vi sau mỗi lần cập nhật model hoặc công cụ.
Cải tiến hoặc rollback: điều chỉnh prompt, routing, guardrail, dữ liệu, model; quay lại phiên bản an toàn khi cần.
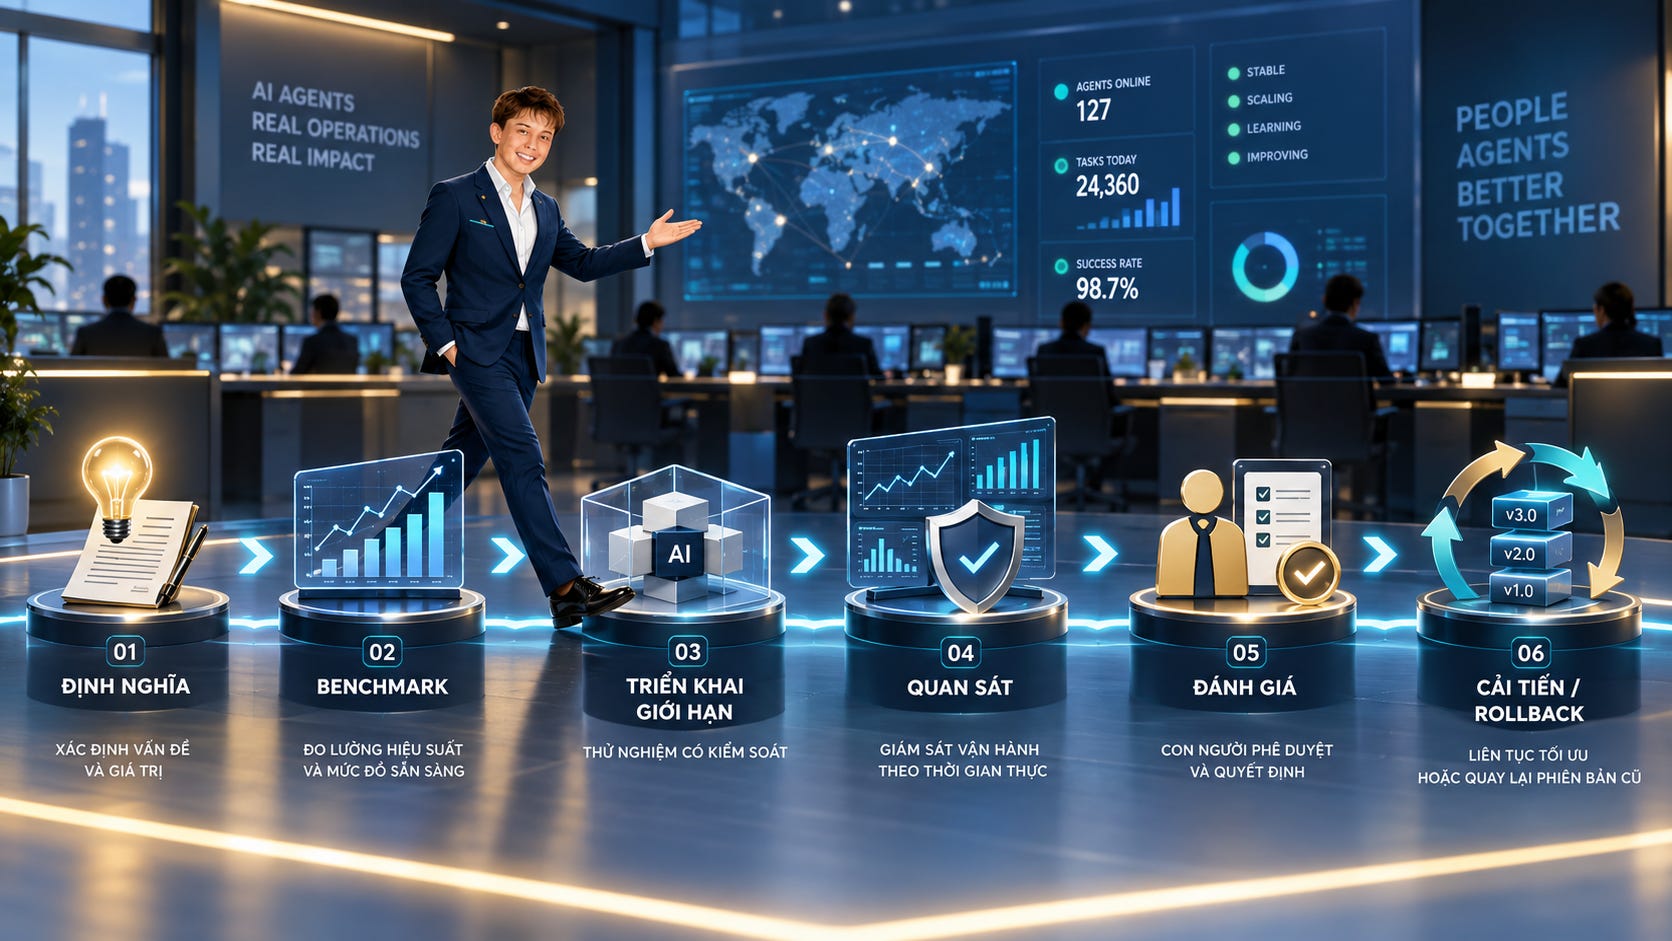
Dashboard tốt không chỉ báo token và latency. Nó phải giúp trả lời các câu hỏi quản trị:
Bao nhiêu phần trăm tác vụ hoàn tất mà không cần can thiệp?
Agent thất bại ở bước nào nhiều nhất?
Tool nào gây timeout hoặc tạo dữ liệu sai?
Loại yêu cầu nào làm chi phí tăng đột biến?
Có quyết định nào vi phạm policy?
Phiên bản mới có thật sự tốt hơn phiên bản cũ trên tập tình huống của doanh nghiệp?
Không có đo lường, “tự chủ” chỉ là một cách khác để nói rằng hệ thống đang hoạt động ngoài tầm nhìn.
Khung thử nghiệm 30 ngày cho đội dự án
Thay vì tranh luận kéo dài về model, doanh nghiệp có thể tổ chức một vòng đánh giá ngắn:
Tuần 1 — Chốt workload và tiêu chí
Chọn một quy trình có giá trị rõ, phạm vi vừa phải và dữ liệu sẵn có. Xác định 30–100 tình huống đại diện. Đặt ngưỡng cho độ chính xác, tool-call success, thời gian hoàn tất, chi phí và tỷ lệ chuyển cho con người.
Tuần 2 — So sánh 2–3 cấu hình
Đừng chỉ so model. Hãy so cấu hình hệ thống: model + prompt + retrieval + công cụ + guardrail. Có thể thử một model lớn, một model nhỏ và một phương án routing lai.
Tuần 3 — Red team và kiểm thử vận hành
Đưa vào dữ liệu thiếu, yêu cầu mâu thuẫn, lỗi công cụ, prompt injection và ca vượt quyền. Đo mức độ khôi phục sau lỗi, không chỉ kết quả ở happy path.
Tuần 4 — Chạy shadow mode
Để Agent xử lý song song nhưng chưa tự động tác động đến hệ thống thật. So sánh quyết định của Agent với kết quả thực tế hoặc chuyên gia nghiệp vụ. Chỉ mở rộng quyền khi số liệu chứng minh hệ thống đủ ổn định.
Kết luận: Chọn kiến trúc trước khi chọn “ngôi sao”
Mô hình mạnh nhất không đồng nghĩa với Agent tốt nhất. Lựa chọn đúng là mô hình — hoặc đội hình mô hình — đạt đủ năng lực suy luận và sử dụng công cụ, trong giới hạn chấp nhận được về độ trễ, chi phí, an toàn và khả năng vận hành.
Nếu chỉ giữ lại ba nguyên tắc, hãy giữ ba điều này:
Benchmark trên quy trình thật, không trên ấn tượng demo.
Tối ưu chi phí trên kết quả thành công, không trên giá token.
Xem LLM là một thành phần trong kiến trúc có kiểm soát, không phải toàn bộ sản phẩm.
Câu hỏi tốt để kết thúc không còn là “Model nào thông minh nhất?”, mà là:
Hệ thống nào tạo ra quyết định đúng, hành động an toàn và giá trị đo được — một cách lặp lại?