

Cách chia nhỏ nhiệm vụ, cô lập ngữ cảnh và thiết kế quyền hạn để AI làm việc như một tổ chức — thay vì một hộp chat quá tải.
Có một cảnh quen thuộc trong nhiều dự án AI doanh nghiệp: ta đưa cho trợ lý AI một bộ tài liệu, vài nghìn dòng log, kết quả kiểm thử, yêu cầu nghiệp vụ và cả lịch sử trao đổi kéo dài nhiều giờ. Ban đầu, câu trả lời có vẻ rất thông minh. Sau đó, hệ thống bắt đầu nhầm lỗi phụ thành lỗi chính, quên một ràng buộc đã thống nhất hoặc đề xuất một thứ không tồn tại trong hệ thống.
Phản xạ tự nhiên là đổi model, tăng context window hoặc viết prompt dài hơn.
Nhưng vấn đề thường không nằm ở “độ thông minh” của model. Nó nằm ở kiến trúc công việc.
Một giám đốc không đọc từng dòng log vận hành, tự kiểm từng hóa đơn rồi đồng thời viết chiến lược quý. Họ giao từng việc cho đúng người, nhận lại báo cáo cô đọng và giữ quyền ra quyết định. Hệ thống AI doanh nghiệp cũng nên được thiết kế như vậy.
Đó là lý do kiến trúc sub-agent đáng được nhìn nhận không phải như một tính năng thời thượng, mà như một cơ chế quản trị độ phức tạp.
Context lớn không đồng nghĩa với context tốt
Context window giống mặt bàn làm việc: mặt bàn rộng hơn giúp ta đặt thêm tài liệu, nhưng không đảm bảo ta nhìn đúng tờ giấy cần thiết. Đây cũng là lý do prompt hay vẫn chưa đủ nếu “bàn làm việc” của AI được thiết kế sai.
Giả sử một tác vụ xử lý sự cố tạo ra:
500 dòng log, trong đó chỉ ba dòng cho biết nguyên nhân;
200 dòng kết quả kiểm thử, trong đó chỉ cần biết ba test thất bại;
tám tệp mã nguồn, nhưng lỗi thực sự nằm ở một điều kiện kiểm tra giá trị rỗng;
hàng chục lượt trao đổi đã lẫn cả giả thuyết đúng, sai và những hướng điều tra bị loại bỏ.
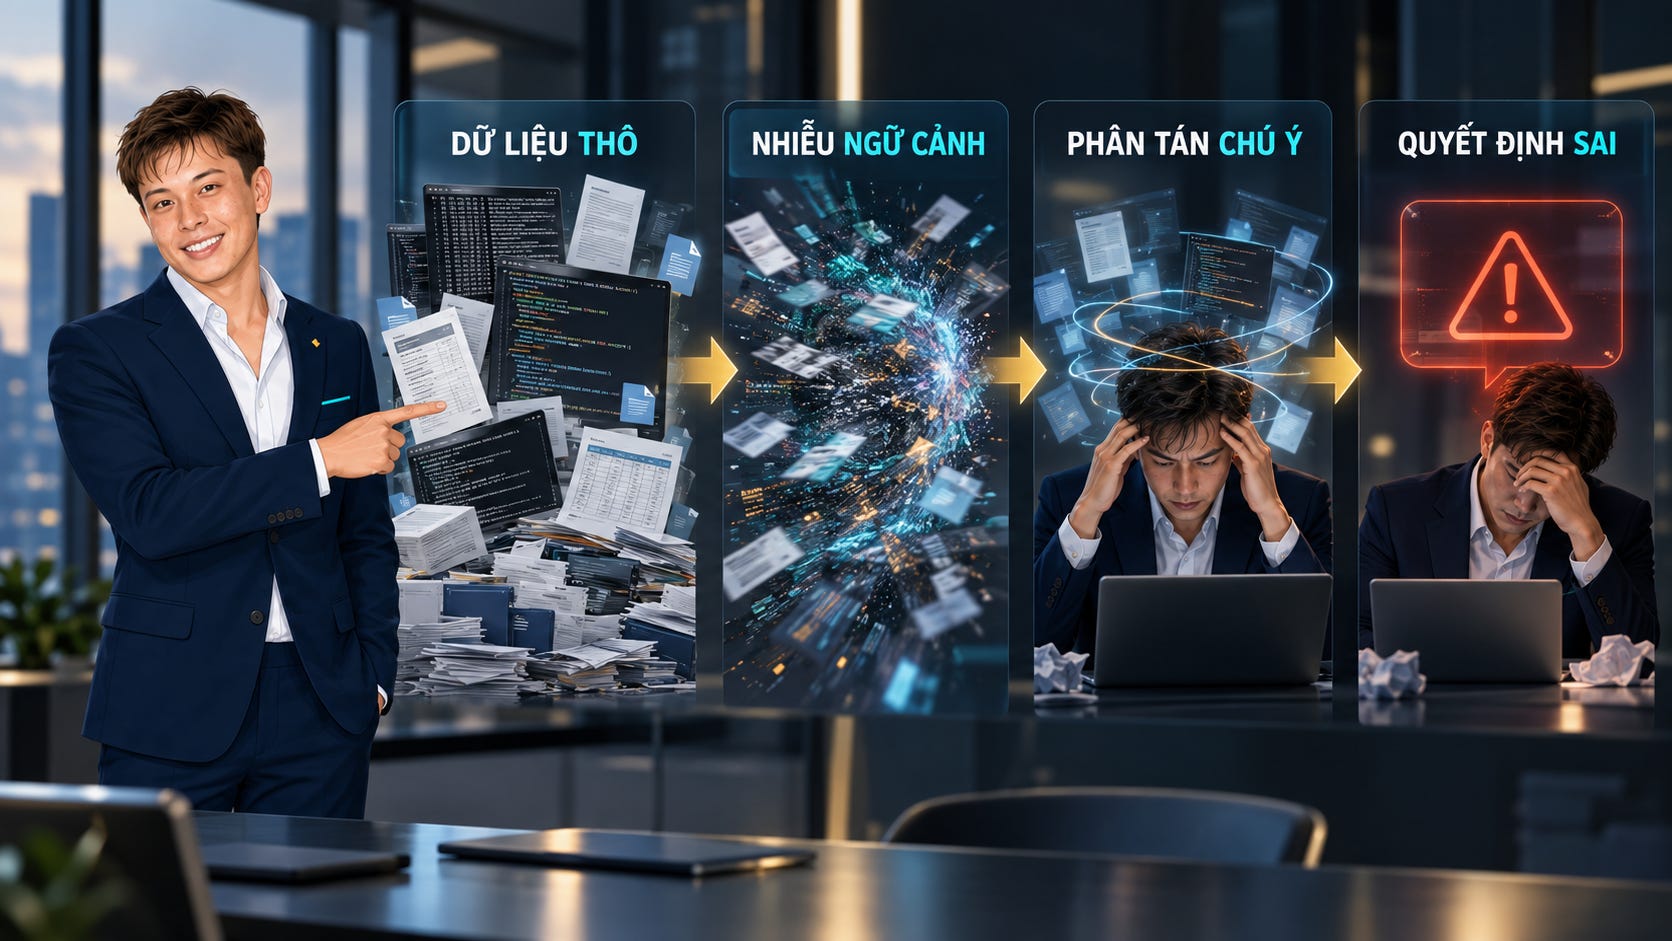
Nếu tất cả cùng chảy vào một cuộc hội thoại, tín hiệu quan trọng sẽ bị pha loãng. Model không “quên” theo nghĩa con người; nó đang phải phân bổ sự chú ý trên một vùng thông tin có tỷ lệ nhiễu quá cao.
Chuỗi nguyên nhân thường diễn ra như sau:
Dữ liệu thô tăng → tín hiệu/nhiễu giảm → chú ý bị phân tán → kết luận thiếu ổn định → con người phải kiểm tra lại nhiều hơn.
Điều đáng nói là vòng lặp này tự khuếch đại. Câu trả lời thiếu chính xác khiến người dùng bổ sung thêm dữ liệu, dữ liệu mới lại làm context nặng hơn, rồi chất lượng tiếp tục giảm.
Vì vậy, câu hỏi kiến trúc đúng không phải là “model chứa được bao nhiêu token?”, mà là:
Thông tin nào thật sự cần đi vào luồng ra quyết định chính?
Sub-agent: phân quyền nhận thức, không chỉ phân chia tác vụ
Một sub-agent là một tác nhân AI được giao một phạm vi trách nhiệm rõ, hoạt động trong ngữ cảnh riêng, sử dụng bộ công cụ được giới hạn và trả về đầu ra theo hợp đồng định sẵn. Nó là một lớp cụ thể trong kiến trúc biến LLM từ hệ thống biết trả lời thành hệ thống biết hành động.
Hình dung main agent như người điều phối:
Nhận mục tiêu kinh doanh và các ràng buộc chung.
Tách mục tiêu thành những nhiệm vụ có thể kiểm chứng.
Giao mỗi nhiệm vụ cho một chuyên gia phù hợp.
Chỉ nhận lại kết luận, bằng chứng và mức độ tin cậy.
Tổng hợp các kết quả để ra quyết định hoặc trình con người phê duyệt.
Giá trị lớn nhất ở đây là phân quyền nhận thức. Sub-agent phân tích log có thể đọc hàng nghìn dòng dữ liệu mà không đổ toàn bộ phần nhiễu về cuộc hội thoại chính. Agent kiểm thử có thể chạy nhiều lệnh, nhưng chỉ trả về bảng “đạt / không đạt” cùng lỗi trọng yếu. Agent rà soát bảo mật chỉ cần quyền đọc, không có lý do gì để được sửa mã nguồn hoặc gọi hệ thống sản xuất.
Bốn lớp cần có trong một kiến trúc sub-agent
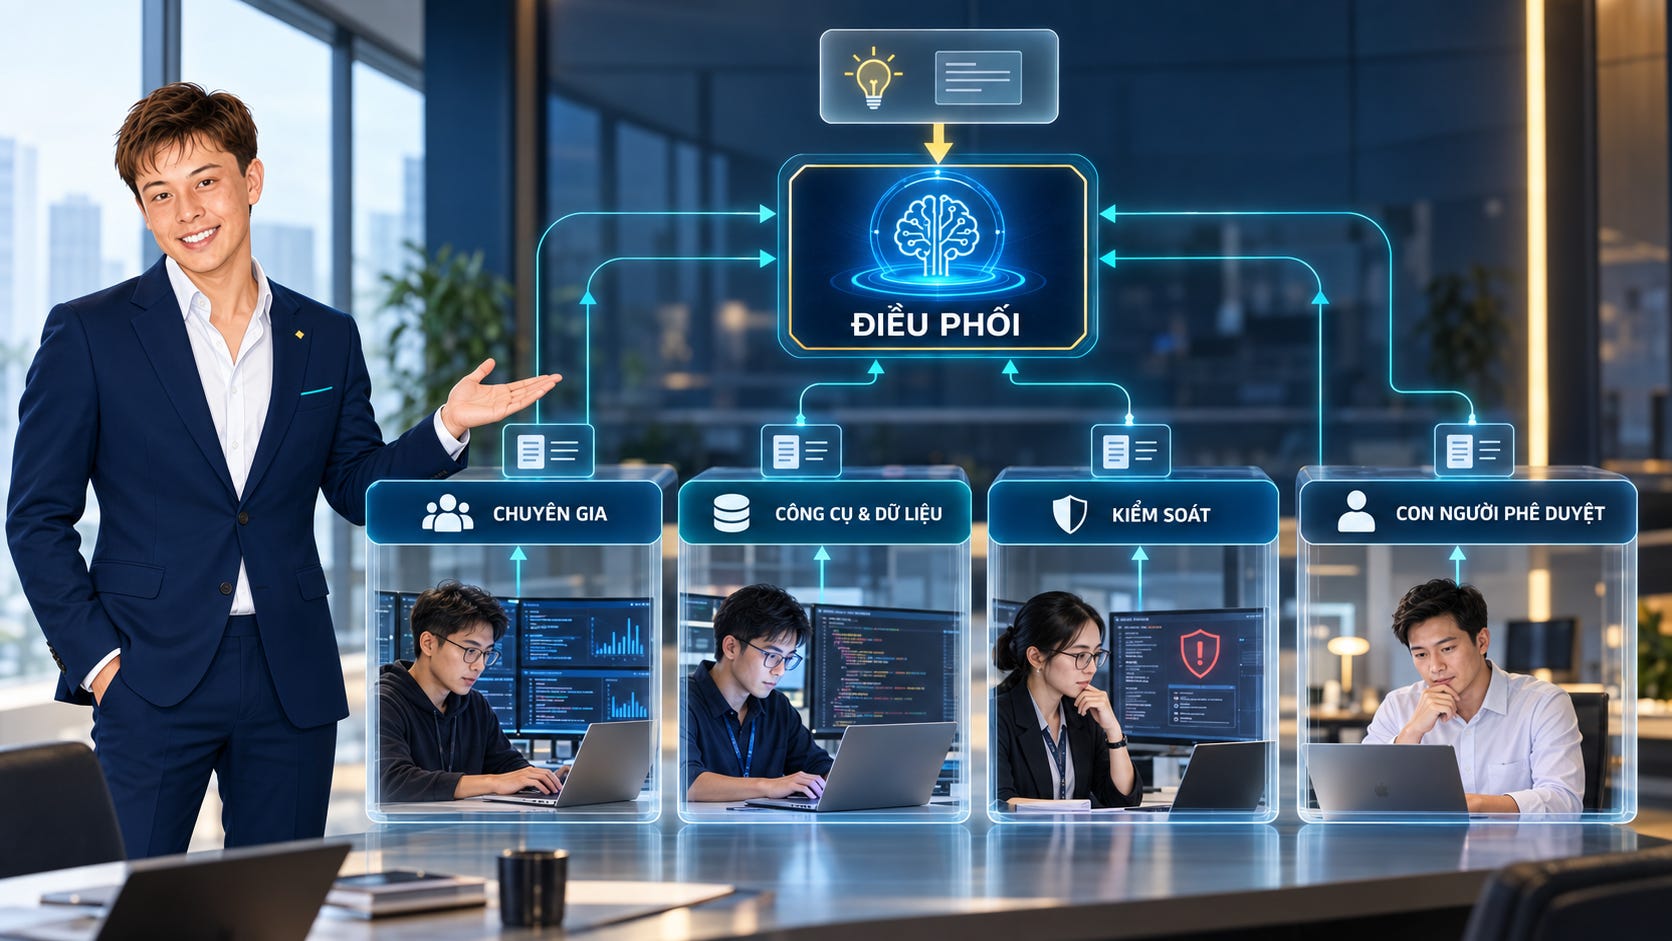
Một thiết kế đủ dùng cho doanh nghiệp thường gồm bốn lớp:
1. Lớp điều phối (orchestration). Nhận yêu cầu, lập kế hoạch, chọn agent, quản lý trạng thái và tổng hợp kết quả. Đây là nơi giữ mục tiêu chung, không phải nơi chứa mọi chi tiết thực thi.
2. Lớp chuyên gia (specialists). Mỗi agent chỉ có một lý do để thay đổi: agent phân tích hợp đồng, agent kiểm tra bảo mật, agent chạy test, agent thẩm định dữ liệu… Trách nhiệm càng rõ, việc đánh giá càng dễ.
3. Lớp công cụ và dữ liệu. Mỗi agent chỉ nhìn thấy những nguồn dữ liệu và thao tác cần thiết. Quyền phải được cấp bằng cơ chế hệ thống, không chỉ bằng một câu dặn “đừng sửa tệp”.
4. Lớp kiểm soát. Gồm quan sát, nhật ký, đánh giá chất lượng, ngưỡng dừng, phê duyệt của con người và quy trình xử lý thất bại. Nếu không có lớp này, đa agent chỉ là nhiều hộp đen nối với nhau.
Kiến trúc đó phản chiếu nhiều nguyên tắc phần mềm đã được kiểm chứng:
Single Responsibility: mỗi agent làm một việc và làm rõ tiêu chuẩn hoàn thành;
Bulkhead: lỗi hoặc nhiễu của một agent được giữ trong một “khoang” riêng;
MapReduce: nhiều agent xử lý song song, agent điều phối tổng hợp kết quả;
Chain of Responsibility: đầu ra có cấu trúc của bước trước trở thành đầu vào của bước sau;
Least Privilege: mỗi agent chỉ có quyền tối thiểu để hoàn thành nhiệm vụ.
Nói cách khác, kiến trúc agent không bắt đầu từ prompt. Nó bắt đầu từ tư duy thiết kế hệ thống.
Năm mô hình triển khai — và khi nào nên dùng
1. Agent chỉ đọc: người quan sát an toàn
Phù hợp với rà soát mã nguồn, phân tích chính sách, kiểm tra hợp đồng hoặc đánh giá kiến trúc. Agent có quyền đọc, tìm kiếm và tổng hợp, nhưng không được ghi hay thực thi.
Đây là điểm khởi đầu tốt nhất cho doanh nghiệp vì rủi ro thấp, giá trị dễ đo và con người vẫn giữ toàn quyền hành động.
2. Agent thực thi: bộ xử lý tác vụ nhiều nhiễu
Phù hợp với chạy test, build, xử lý log hoặc trích xuất dữ liệu. Agent được phép tạo nhiều đầu ra trung gian trong vùng cô lập, rồi trả về một bản tóm tắt có cấu trúc.
Điều kiện bắt buộc là giới hạn phạm vi thực thi, thời gian, tài nguyên và địa chỉ mạng có thể truy cập.
3. Song song: hội đồng chuyên gia
Khi một quyết định cần nhiều góc nhìn độc lập, main agent có thể giao đồng thời cho agent bảo mật, hiệu năng và chất lượng. Sau đó, kết quả được hợp nhất thành một báo cáo.
Ưu điểm là tốc độ và tính đa chiều. Nhược điểm là có thể xuất hiện kết luận mâu thuẫn, vì vậy lớp tổng hợp phải có quy tắc ưu tiên và cơ chế yêu cầu bằng chứng.
4. Pipeline: dây chuyền có hợp đồng bàn giao
Một agent phân tích yêu cầu, agent kế tiếp đề xuất giải pháp, agent khác kiểm chứng, cuối cùng agent biên tập tạo báo cáo. Mỗi bước phụ thuộc vào đầu ra của bước trước.
Pipeline chỉ ổn định khi hợp đồng đầu ra đủ chặt. Nếu agent đầu tiên trả về văn bản tùy hứng, mọi bước phía sau sẽ phải đoán.
5. Mô hình nhóm: điều phối động
Phù hợp với nhiệm vụ dài, có nhiều nhánh và cần thay đổi kế hoạch theo phát hiện mới. Đây cũng là mô hình khó kiểm soát nhất, vì chi phí phối hợp, quyền hạn và truy vết quyết định tăng nhanh.
Doanh nghiệp không nên bắt đầu ở cấp độ này chỉ vì nó nghe “tự chủ” hơn. Tự chủ là kết quả của năng lực kiểm soát tốt, không phải là mặc định.
Đừng dùng sub-agent cho mọi việc
Chia nhỏ luôn có chi phí: tạo ngữ cảnh mới, truyền đạt nhiệm vụ, chuẩn hóa đầu ra, hợp nhất kết quả và xử lý sai lệch giữa các agent.
Quy tắc thực dụng nhất là nhìn vào tỷ lệ đầu vào so với đầu ra.
Tình huống
Dấu hiệu
Cách phù hợp
Đầu vào rất lớn, đầu ra nhỏ
Log, hồ sơ, hàng chục tệp; chỉ cần vài kết luận
Sub-agent cô lập và tóm tắt
Nhiều góc nhìn độc lập
Bảo mật, pháp lý, hiệu năng có thể đánh giá riêng
Agent song song
Các bước phụ thuộc rõ
Phân tích → thiết kế → kiểm chứng
Pipeline
Tác vụ nhỏ, ít nhiễu
Sửa một hàm, viết một chú thích
Làm trực tiếp ở main agent
Yêu cầu mơ hồ, chưa có tiêu chí
Chưa biết thế nào là “xong”
Con người làm rõ trước
Hành động rủi ro cao
Thanh toán, xóa dữ liệu, thay đổi sản xuất
Agent đề xuất, con người phê duyệt
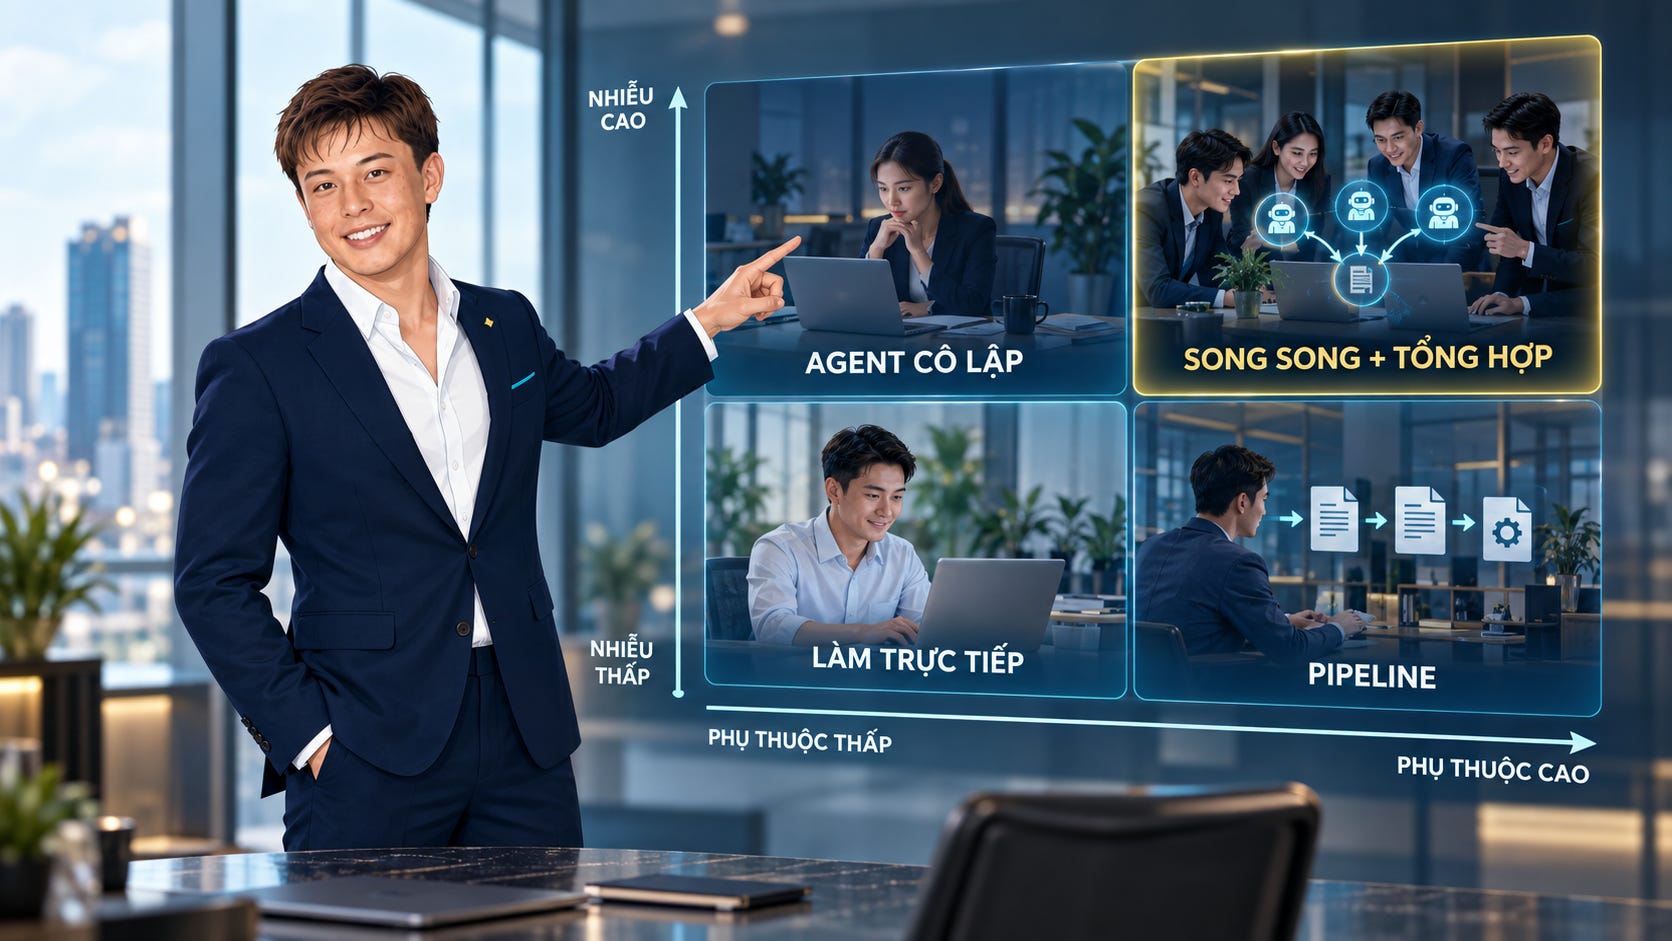
Nếu đầu vào xấp xỉ đầu ra, một agent riêng thường không đáng. Nếu đầu vào lớn hơn đầu ra nhiều lần, hoặc tạo ra lượng lớn dữ liệu trung gian, cô lập context bắt đầu mang lại lợi ích rõ rệt.
Hợp đồng đầu ra quan trọng hơn prompt dài
Trong hệ thống nhiều agent, giao tiếp là message passing, không phải “đọc suy nghĩ” của nhau. Agent sau chỉ làm việc tốt nếu agent trước bàn giao đúng cấu trúc.
Thay vì yêu cầu “hãy phân tích log thật kỹ”, hãy quy định đầu ra:
yaml
status: confirmed | suspected | inconclusive
root_cause:
  file: string
  line: number
  explanation: string
evidence:
  - source: string
    excerpt: string
confidence: 0.0-1.0
next_action:
  owner: human | agent
  action: string
Hợp đồng này tạo ra ba lợi ích.
Thứ nhất, agent điều phối không cần đọc lại toàn bộ dữ liệu thô. Thứ hai, hệ thống có thể tự động kiểm tra trường thiếu hoặc giá trị không hợp lệ. Thứ ba, con người biết một kết luận đến từ đâu và nên tin nó đến mức nào.
Một đầu ra tốt nên trả lời năm câu hỏi: đã phát hiện gì, bằng chứng nào hỗ trợ, mức độ chắc chắn ra sao, còn điều gì chưa biết và hành động tiếp theo là gì.
Quyền hạn: biến lời dặn thành rào chắn
Sai lầm phổ biến là cho mọi agent cùng một bộ quyền, rồi dùng prompt để nhắc chúng “chỉ đọc” hoặc “không truy cập dữ liệu nhạy cảm”.
Đó không phải kiểm soát; đó là kỳ vọng. Khi đưa LLM vào môi trường thật, doanh nghiệp cần xây cả hệ thống kiểm soát thay vì chỉ gọi mô hình.
Quyền nên được thiết kế theo ba chiều:
Dữ liệu: agent được đọc kho nào, trường nào cần che, dữ liệu được giữ bao lâu;
Công cụ: chỉ đọc, được thực thi, được ghi vào vùng tạm hay được thay đổi hệ thống thật;
Mạng: được gọi endpoint nào, trong môi trường nào, với hạn mức bao nhiêu.
Một agent review mã nguồn chỉ cần đọc và tìm kiếm. Một agent chạy test có thể cần shell nhưng không cần thông tin xác thực sản xuất. Một agent đề xuất thay đổi có thể tạo bản vá, song việc merge hoặc deploy nên thuộc về cổng phê duyệt riêng.
Nguyên tắc đơn giản: nếu một quyền không trực tiếp phục vụ tiêu chí hoàn thành, đừng cấp nó.
Token economics: tiết kiệm là hệ quả, không phải mục tiêu duy nhất
Sub-agent đôi khi giảm chi phí vì dữ liệu thô không bị mang theo trong nhiều lượt trao đổi tiếp theo. Thay vì giữ 10.000 token kết quả test trong luồng chính, ta chỉ giữ một bản tóm tắt 100 token.
Tuy nhiên, mỗi agent mới cũng có chi phí khởi tạo, context và tổng hợp. Cơ chế cache có thể làm giảm lợi ích tài chính của việc cô lập. Vì vậy, không nên hứa hẹn một tỷ lệ tiết kiệm cố định.
Ba chỉ số có ý nghĩa hơn tổng số token là:
Tỷ lệ thông tin hữu ích trong context chính;
Số lần con người phải sửa hoặc yêu cầu làm lại;
Khả năng truy vết từ quyết định về bằng chứng.
Trong môi trường doanh nghiệp, một câu trả lời rẻ nhưng không kiểm chứng được có thể đắt hơn rất nhiều so với một quy trình tốn thêm vài lượt gọi model.
Lộ trình triển khai 30 ngày
Tuần 1: chọn một luồng có tỷ lệ đầu vào/đầu ra cao
Đừng bắt đầu bằng “xây một đội AI tự chủ”. Hãy chọn một điểm đau cụ thể: phân loại ticket, tóm tắt log, rà soát hợp đồng hoặc kiểm tra mã. Ghi lại baseline về thời gian, lỗi và số lần làm lại. Nếu chưa tách được triệu chứng khỏi nguyên nhân, hãy hiểu đúng bài toán trước khi xây AI.
Tuần 2: định nghĩa một chuyên gia và hợp đồng đầu ra
Giới hạn agent ở một trách nhiệm. Viết tiêu chí hoàn thành, schema đầu ra, nguồn dữ liệu được phép đọc và những hành động bị cấm. Tạo bộ ca kiểm thử gồm cả trường hợp bình thường lẫn dữ liệu nhiễu.
Tuần 3: thêm lớp kiểm soát
Ghi log quyết định, đo độ trễ, chi phí, tỷ lệ schema hợp lệ và mức độ đồng thuận với người đánh giá. Đặt ngưỡng để agent chuyển việc cho con người khi bằng chứng thiếu hoặc độ tin cậy thấp.
Tuần 4: mới cân nhắc song song hoặc pipeline
Chỉ thêm agent thứ hai khi có một lý do kiến trúc rõ: cần góc nhìn độc lập, cần cô lập một loại nhiễu mới hoặc cần tách quyền. Nếu không chỉ ra được lý do ấy, hãy tiếp tục cải thiện agent đầu tiên.
Câu hỏi dành cho lãnh đạo
Trước khi phê duyệt một kiến trúc đa agent, tôi thường muốn đội dự án trả lời sáu câu hỏi:
Mỗi agent có đúng một trách nhiệm có thể kiểm chứng không?
Dữ liệu thô nào được giữ ngoài context chính?
Hợp đồng bàn giao giữa các agent có máy kiểm tra được không?
Quyền nào được cưỡng chế bằng hệ thống thay vì lời nhắc?
Khi hai agent mâu thuẫn, ai hoặc quy tắc nào phân xử?
Điểm nào bắt buộc con người phê duyệt?
Nếu chưa trả lời được, vấn đề không nằm ở model. Kiến trúc vẫn chưa sẵn sàng.
Kết
Tương lai của AI doanh nghiệp không nhất thiết là một siêu agent biết làm mọi thứ. Khả năng cao hơn, đó là một hệ thống gồm nhiều tác nhân nhỏ, có chuyên môn, quyền hạn và hợp đồng phối hợp rõ ràng — được điều phối quanh mục tiêu kinh doanh và nằm trong những rào chắn có thể kiểm toán.
Sub-agent không làm biến mất độ phức tạp. Nó đưa độ phức tạp về đúng chỗ: dữ liệu thô ở nơi xử lý dữ liệu thô, quyền nhạy cảm ở nơi được kiểm soát, quyết định chiến lược ở luồng chính, và phán đoán rủi ro cao ở lại với con người.
Khi thiết kế theo cách đó, AI không còn là một hộp chat cố gắng nhớ tất cả. Nó bắt đầu vận hành như một tổ chức biết phân công, báo cáo và chịu trách nhiệm.
Nếu chỉ được chọn một tác vụ để thử kiến trúc sub-agent trong 30 ngày tới, bạn sẽ chọn tác vụ nào — và đâu là đầu ra tối thiểu để biết thử nghiệm đó thành công?