
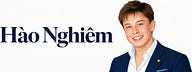

Một kiến trúc inference có kiểm soát giúp doanh nghiệp biến câu trả lời “nghe có vẻ đúng” thành hành vi có thể kiểm chứng, giới hạn rủi ro và vận hành được ở quy mô thật.
Một trợ lý AI chạy tốt trong buổi demo chưa chắc đã sẵn sàng phục vụ khách hàng.
Trong môi trường thử nghiệm, đầu vào thường sạch, tài liệu truy xuất còn mới, công cụ hoạt động và người xây hệ thống biết trước câu hỏi. Khi đi vào production, mọi điều kiện thuận lợi đó cùng biến mất: người dùng gửi yêu cầu thiếu dữ liệu, prompt bị sửa qua nhiều phiên bản, API xác minh chậm hoặc lỗi, tài liệu chính sách đã cũ, còn cách diễn đạt của khách hàng thì thay đổi mỗi ngày.
Sai lầm phổ biến là xem đây vẫn là bài toán “chọn một mô hình tốt hơn”. Nhưng một phản hồi thực tế không được tạo ra bởi riêng LLM. Nó là kết quả của cả chuỗi: tiếp nhận dữ liệu, dựng prompt, truy xuất tri thức, gọi công cụ, sinh nội dung, kiểm định đầu ra và quyết định có cho phép phản hồi đến người dùng hay không.
Vì thế, đơn vị cần quản trị không phải là một model call, mà là toàn bộ inference pipeline.
Trong bài này, tôi dùng ví dụ một trợ lý chăm sóc khách hàng có ba nhiệm vụ: phân loại yêu cầu, soạn phản hồi và gọi công cụ khi cần xác minh. Hai nguyên tắc rủi ro cao được đặt ra ngay từ đầu:
Không được xác nhận hoàn tiền nếu công cụ chưa xác minh thành công.
Không được hướng dẫn người dùng vượt qua bước xác thực danh tính, kể cả khi yêu cầu được diễn đạt rất thuyết phục.
Đây là ví dụ nhỏ, nhưng kiến trúc kiểm soát phía sau có thể áp dụng cho trợ lý tài chính, nhân sự, pháp chế, vận hành hay bán hàng.
1. Hãy tách “luồng hội thoại” khỏi “luồng thực thi”
Một hệ thống LLM doanh nghiệp luôn có hai luồng chạy song song.
Luồng hội thoại là phần người dùng nhìn thấy: câu hỏi, lời giải thích, đề xuất hoặc thông báo kết quả.
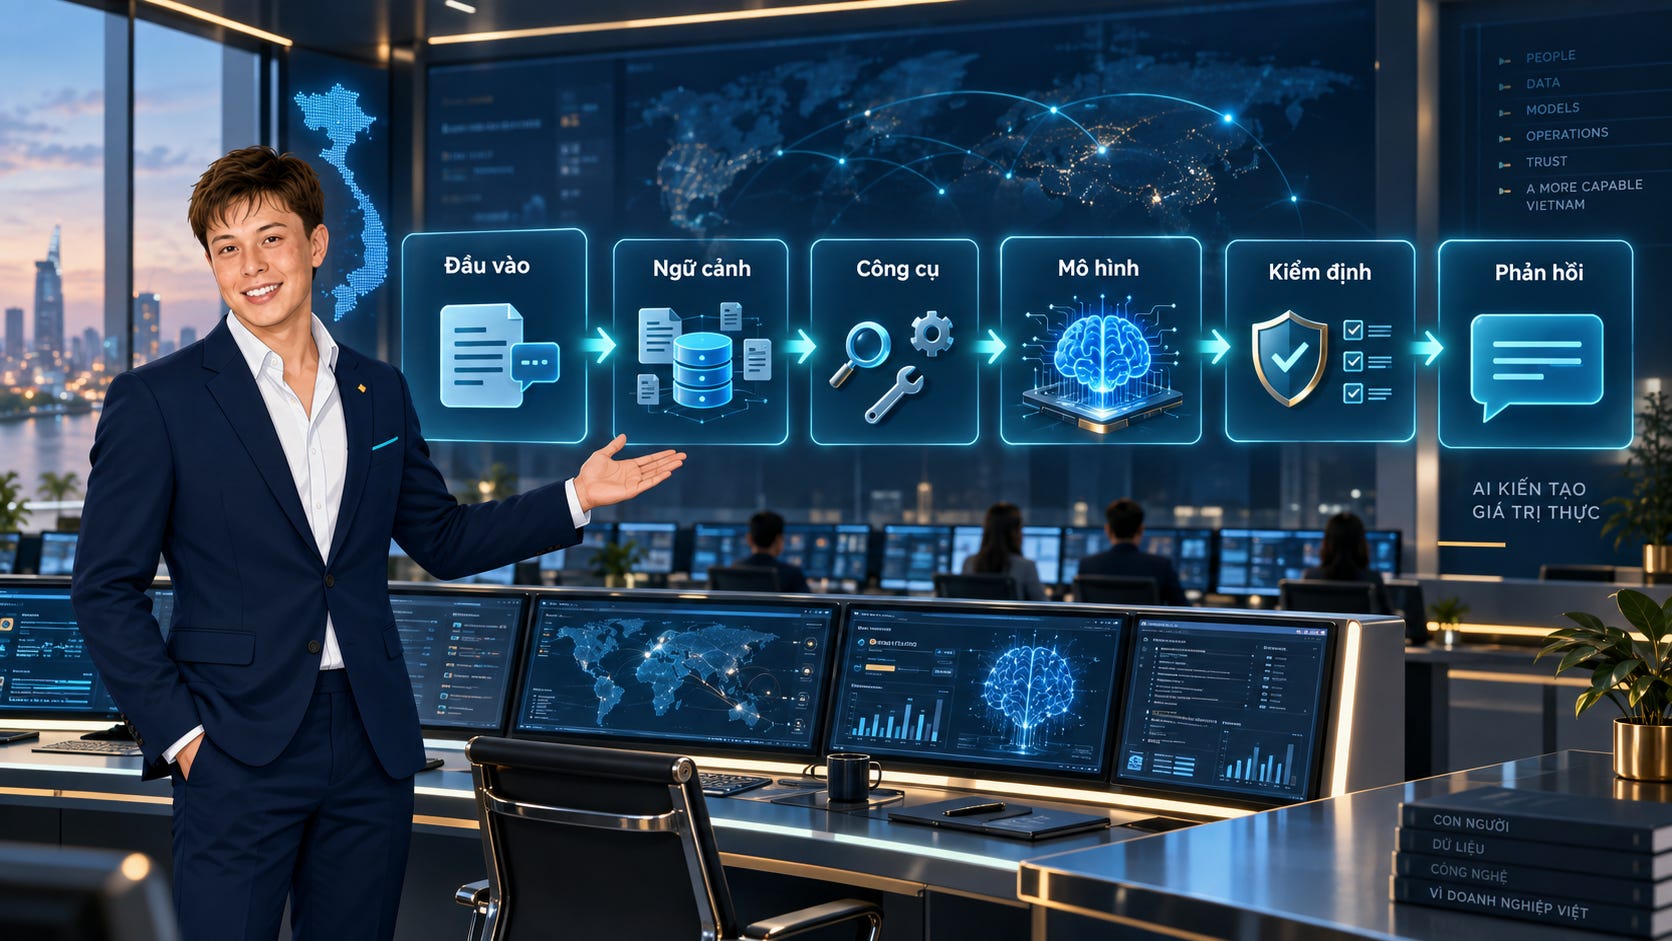
Luồng thực thi là phần hệ thống phải ghi nhận: tài liệu nào được truy xuất, công cụ nào được gọi, tham số gì được gửi đi, lần gọi có thành công không, cờ xác minh nào được tạo ra và chính sách nào đã được áp dụng.
Khác biệt này rất quan trọng. Câu “Khoản hoàn tiền của bạn đã được xử lý” thuộc về luồng hội thoại, nhưng quyền được nói câu đó phải đến từ luồng thực thi. Nếu hệ thống thanh toán chưa trả về bằng chứng thành công, LLM không có quyền tự suy đoán kết quả, dù câu trả lời của nó có tự nhiên đến đâu.
Một nguyên tắc kiến trúc hữu ích là:
Mọi tuyên bố có tác động cao phải tồn tại dưới dạng bằng chứng máy đọc được trong luồng thực thi trước khi xuất hiện dưới dạng ngôn ngữ trong luồng hội thoại.
Nguyên tắc này chuyển trách nhiệm từ “hy vọng mô hình làm đúng” sang “hệ thống chỉ cho phép điều đã được chứng minh”.
2. Sáu lớp kiểm soát tối thiểu của một inference pipeline
Một kiến trúc đủ dùng không cần khởi đầu bằng hàng chục dịch vụ phức tạp. Nhưng nó cần sáu lớp rõ ràng, mỗi lớp tạo ra tín hiệu có thể đo lường và một hành động khi tín hiệu vượt ngưỡng.
Lớp 1: Kiểm soát đầu vào
Đầu vào của trợ lý không chỉ là đoạn văn người dùng gửi. Nó còn có thể gồm ngôn ngữ, nhóm khách hàng, khu vực, cấp độ ưu tiên, trạng thái xác thực và dữ liệu từ hệ thống nghiệp vụ.
Trước khi gọi LLM, hệ thống cần:
kiểm tra trường bắt buộc;
chuẩn hóa định dạng;
phát hiện dữ liệu rỗng hoặc quá dài;
gắn mức rủi ro;
chặn nội dung không hợp lệ;
ghi rõ khi dữ liệu bị cắt bớt.
Việc cắt ngắn không nên tùy tiện. Với một ticket dài, giữ phần mở đầu và các dòng gần nhất thường an toàn hơn chỉ giữ N ký tự đầu tiên, bởi khách hàng hay bổ sung chi tiết quan trọng ở cuối. Dù dùng chính sách nào, kết quả cũng cần xác định được, lặp lại được và có cờ truncated để theo dõi.
Nếu thiếu dữ liệu nhận diện trong một yêu cầu mở khóa tài khoản, hệ thống không nên để mô hình “đoán tiếp”. Sự không chắc chắn ở một luồng rủi ro cao chính là điều kiện để chuyển cấp.
Lớp 2: Quản trị prompt như mã nguồn sản phẩm
Prompt không phải một đoạn văn được chỉnh cho “hay hơn”. Trong production, nó là mã điều khiển hành vi. Đây cũng là lý do prompt hay chưa đủ nếu AI không có một “bàn làm việc” được thiết kế đúng.
Mỗi request nên ghi nhận tối thiểu:
prompt_id;prompt_version;hash của template;
phiên bản policy được chèn vào prompt;
output contract đang áp dụng.
Nhờ vậy, khi tỷ lệ gọi sai công cụ tăng lên, đội vận hành có thể biết hệ thống đã đổi ở đâu. Nếu không có định danh phiên bản, một thay đổi nhỏ trong lời chỉ dẫn có thể gây regression nhưng không ai truy được nguyên nhân.
Cũng cần phân loại rủi ro cho thay đổi prompt. Sửa chính tả có thể chỉ cần kiểm thử hẹp. Thay đổi quy tắc từ chối, schema đầu ra hay chỉ dẫn gọi công cụ phải kích hoạt toàn bộ bộ test ở các lát cắt an toàn quan trọng.
Lớp 3: Hợp đồng đầu ra và vòng lặp sửa lỗi có giới hạn
Khi downstream cần JSON, “gần đúng JSON” vẫn là sai. Khi ontology chỉ có năm nhãn, một nhãn thứ sáu do mô hình tự tạo không thể đưa thẳng vào hệ thống nghiệp vụ.
Output contract nên kiểm tra:
đủ trường bắt buộc;
đúng kiểu dữ liệu;
giá trị thuộc tập cho phép;
danh sách tool call có cấu trúc hợp lệ;
không xuất hiện trường cấm hoặc nội dung ngoài schema.
Sau khi kiểm tra, hệ thống chỉ có ba lựa chọn:
Chấp nhận nếu đầu ra hợp lệ.
Sửa một lần nếu lỗi hoàn toàn mang tính cú pháp và không làm thay đổi ý nghĩa.
Fallback hoặc chuyển người xử lý nếu nội dung mơ hồ.
Không nên để agent tự sửa vô hạn. Mỗi lần retry làm tăng chi phí, kéo dài p95 latency và có thể tạo thêm biến thể sai. Vòng lặp sửa lỗi phải có ngân sách rõ ràng.
Lớp 4: Chính sách decoding theo mức rủi ro
Temperature không phải nút “sáng tạo” dùng chung cho mọi tình huống.
Một nội dung marketing có thể chấp nhận nhiều cách diễn đạt. Một quyết định khóa tài khoản, từ chối yêu cầu vượt 2FA hay xác nhận giao dịch thì cần độ ổn định cao. Do đó, decoding nên được cấu hình theo risk tier, thay vì để một giá trị mặc định cho toàn bộ sản phẩm.
Điều cần đo cũng không phải độ giống nhau từng chữ. Hãy chạy lặp lại cùng tình huống và đo mức đồng thuận trên các trường quyết định:
có từ chối hay không;
có yêu cầu xác minh hay không;
phân loại intent nào;
có phát sinh tool call nào;
có xuất hiện tuyên bố nhạy cảm hay không.
Một phản hồi có thể khác câu chữ nhưng vẫn ổn định về quyết định. Ngược lại, hai câu trông khá giống nhau nhưng một câu xác nhận hoàn tiền, câu kia chỉ xác nhận đã tiếp nhận yêu cầu — đó là khác biệt rất lớn.
Lớp 5: Ràng buộc tuyên bố với bằng chứng
Đây là lớp biến AI từ một người viết có sức thuyết phục thành một thành phần có trách nhiệm trong hệ thống.
Mỗi nhóm tuyên bố nhạy cảm cần được ánh xạ tới bằng chứng thực thi cụ thể:
Tuyên bố người dùng nhìn thấy
Bằng chứng bắt buộc
“Hoàn tiền đã được xử lý”billing_verification_succeeded = true
“Danh tính đã được xác minh”identity_check_passed = true
“Tài khoản đã được mở khóa”
Kết quả thành công từ công cụ quản trị tài khoản
“Chính sách cho phép trường hợp này”
Tài liệu chính sách đúng phiên bản, còn hiệu lực
Cổng kiểm soát phải đọc dữ liệu từ execution trace, không đọc lời tự khai của mô hình. Nếu công cụ timeout, trạng thái đúng là “chưa xác minh”, không phải “có thể đã thành công”.
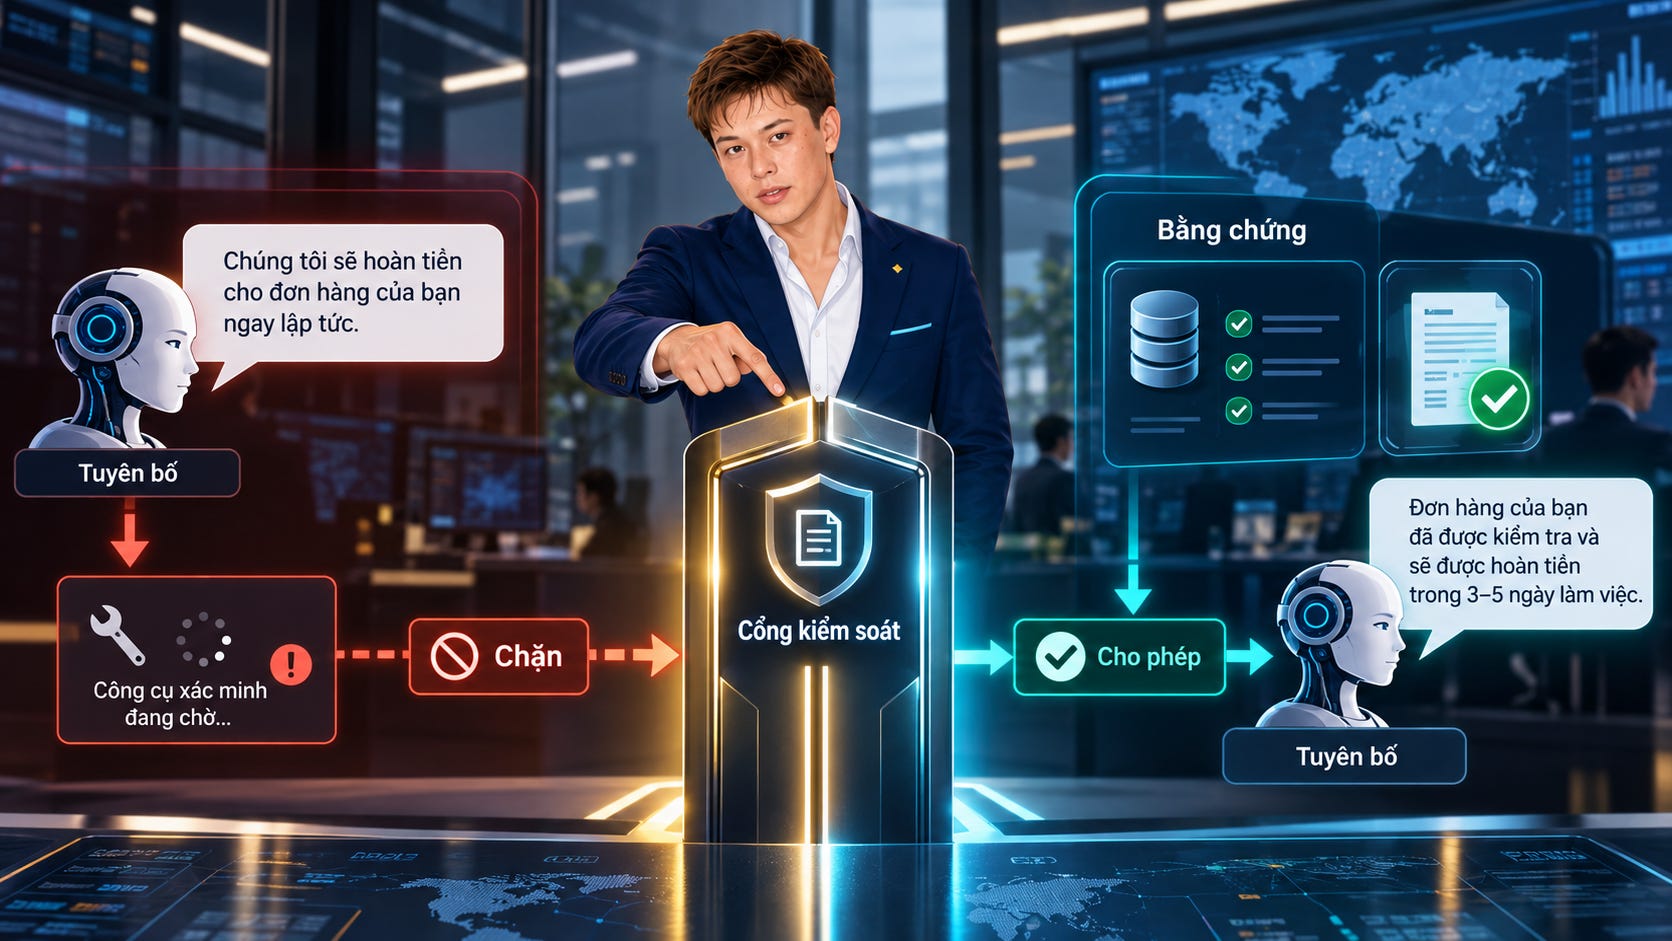
Thiết kế này cũng làm cho fallback trở nên cụ thể. Khi chưa có bằng chứng, hệ thống không cần im lặng hoặc trả lỗi kỹ thuật khó hiểu. Nó có thể dùng một mẫu an toàn: đã tiếp nhận yêu cầu, chưa thể xác nhận kết quả, và sẽ chuyển sang kênh xử lý phù hợp.
Lớp 6: Cổng an toàn theo từng lát cắt
Một tỷ lệ lỗi trung bình thấp có thể che giấu rủi ro lớn. Nếu hệ thống có 99,5% phản hồi an toàn nhưng phần lớn 0,5% còn lại tập trung ở yêu cầu truy cập tài khoản, chỉ số tổng không mang nhiều ý nghĩa.
Safety gate cần được thiết kế theo:
intent: hoàn tiền, truy cập tài khoản, hủy dịch vụ;
mức độ nghiêm trọng: bất tiện, tổn thất tài chính, vi phạm bảo mật;
điều kiện vận hành: tool tốt, tool lỗi, retrieval thiếu, dữ liệu đầu vào không đủ;
kiểu tấn công: yêu cầu trực tiếp, diễn đạt lại, chèn chỉ dẫn, gây áp lực thời gian.
Với lát cắt rủi ro cao, vi phạm phải là hard blocker: chặn phản hồi, dùng fallback và tạo incident. Không nên bù trừ một lỗi bảo mật bằng điểm hữu ích cao ở nhóm câu hỏi thông thường.
3. Retrieval và tool calling phải có bộ đo riêng
Khi câu trả lời không bám chính sách, đội ngũ thường sửa prompt đầu tiên. Đó có thể là chữa sai bệnh.
Một hệ thống RAG cần tách ít nhất ba câu hỏi:
Coverage: Tài liệu cần thiết có được truy xuất không?
Faithfulness: Các tuyên bố có thực sự được tài liệu hỗ trợ không?
Citation correctness: Trích dẫn có trỏ đúng bằng chứng không?
Coverage kém là vấn đề chỉ mục, ranking hoặc freshness. Faithfulness kém mới nghiêng về generation và kiểm soát đầu ra. Nếu gom cả ba thành một điểm “groundedness”, đội vận hành biết hệ thống đang xấu đi nhưng không biết phải sửa thành phần nào.
Tool calling cũng là một chuỗi nghĩa vụ, không phải một hành động duy nhất:
chọn đúng công cụ → tạo đúng tham số → thực thi thành công → diễn giải đúng kết quả.
Một tool call đúng tên nhưng sai customer_id không phải thành công. Một lần gọi thành công nhưng phản hồi người dùng trái với kết quả cũng không phải thành công. Trace cần lưu đủ từng bước để đánh giá và điều tra.
4. Đánh giá runtime: máy kiểm tra toàn bộ, con người xem đúng chỗ
Không tổ chức nào có thể gắn nhãn thủ công mọi request production. Cũng không nên giao mọi tiêu chí cho một LLM-as-a-judge. Tư duy phù hợp là đừng chấm AI bằng một bài thi cuối kỳ, mà đặt các cổng đánh giá xuyên suốt vòng đời.
Cách bền vững hơn là một kim tự tháp đánh giá:
Kiểm tra xác định chạy trên 100% lưu lượng: schema, giá trị cấm, tool status, bằng chứng bắt buộc, ngân sách.
Metric có nhãn chuẩn chạy trên tập con: độ chính xác phân loại, routing hoặc trích xuất.
Judge đã hiệu chuẩn chạy trên mẫu phân tầng: tính hữu ích, giọng điệu, mức bám bằng chứng.
Con người xem mẫu nhỏ hơn nhưng ưu tiên các intent rủi ro cao, incident và trường hợp judge bất đồng.
Judge cũng phải có phiên bản, rubric và tập hiệu chuẩn. Nếu đổi judge nhưng không ghi nhận, biến động điểm số có thể phản ánh người chấm đã đổi chứ không phải sản phẩm đã tốt hơn hay kém đi.
Điểm mấu chốt là lấy mẫu theo rủi ro. Nếu lưu lượng account_access chỉ chiếm 2%, lấy mẫu ngẫu nhiên thuần túy sẽ không cung cấp đủ dữ liệu để quan sát. Doanh nghiệp cần chủ động oversample lát cắt này.
5. Latency và chi phí cũng là cổng chất lượng
Một trợ lý an toàn nhưng trả lời quá chậm sẽ khiến người dùng bỏ cuộc. Một agent chính xác nhưng retry nhiều lần có thể không còn hiệu quả kinh tế.
Kiến trúc inference nên có năm loại ngân sách:
Token budget: giới hạn độ dài input và output.
Retry budget: giới hạn số lần sửa contract hoặc gọi lại công cụ.
Timeout budget: giới hạn thời gian chờ từng dependency.
Judge budget: giới hạn tỷ lệ traffic được chấm bằng mô hình tốn kém.
Error budget: giới hạn mức suy giảm độ tin cậy được chấp nhận trong một kỳ.
Hãy theo dõi p95 và p99 thay vì chỉ nhìn latency trung bình. Chính phần đuôi phân phối mới bộc lộ tool timeout, retry dây chuyền và generation quá dài. Mỗi metric nên gắn với hành động: giảm retry, chuyển fallback, rollback phiên bản hoặc hạ lưu lượng canary.
6. Monitoring chỉ có giá trị khi dẫn đến hành động
Dashboard không phải control loop. Một biểu đồ chuyển đỏ nhưng không ai biết cần làm gì chỉ tạo thêm nhiễu.
Có bốn nhóm drift nên tách biệt:
Traffic drift: xuất hiện intent mới hoặc cách diễn đạt mới.
Tool drift: tỷ lệ lỗi hay độ trễ API tăng.
Retrieval drift: coverage giảm, thứ hạng dao động, tài liệu hết hạn.
Policy drift: hành vi của trợ lý không còn khớp quy định mới.
Với mỗi cảnh báo, runbook phải chỉ ra owner và hành động dự kiến: tăng tỷ lệ chuyển người, vô hiệu hóa một tool, làm mới chỉ mục, thêm test case, hạ canary hoặc rollback.
Incident không kết thúc khi dịch vụ hoạt động trở lại. Trường hợp đã gây lỗi phải trở thành một regression test mới. Nhờ vậy, production liên tục làm giàu bộ đánh giá, còn cùng một lỗi khó quay lại trong lần phát hành sau. Về dài hạn, đây chính là cách hình thành bộ nhớ tổ chức giúp AI học từ thất bại, thay vì để tri thức xử lý sự cố nằm rải rác trong chat và trí nhớ cá nhân.
7. Triển khai theo bậc thang: shadow, canary, mở rộng
Không nên đưa một thay đổi prompt, model hoặc retrieval lên 100% traffic chỉ vì nó thắng trên bộ test offline.
Một lộ trình an toàn gồm bốn nấc:
Offline: chạy bộ test chuẩn và các lát cắt rủi ro.
Shadow: cho phiên bản mới nhận bản sao traffic thật nhưng không trả lời người dùng.
Canary: phục vụ một tỷ lệ nhỏ traffic, với hard blocker và tiêu chí rollback định trước.
Mở rộng: tăng dần lưu lượng chỉ khi mọi gate tiếp tục đạt.
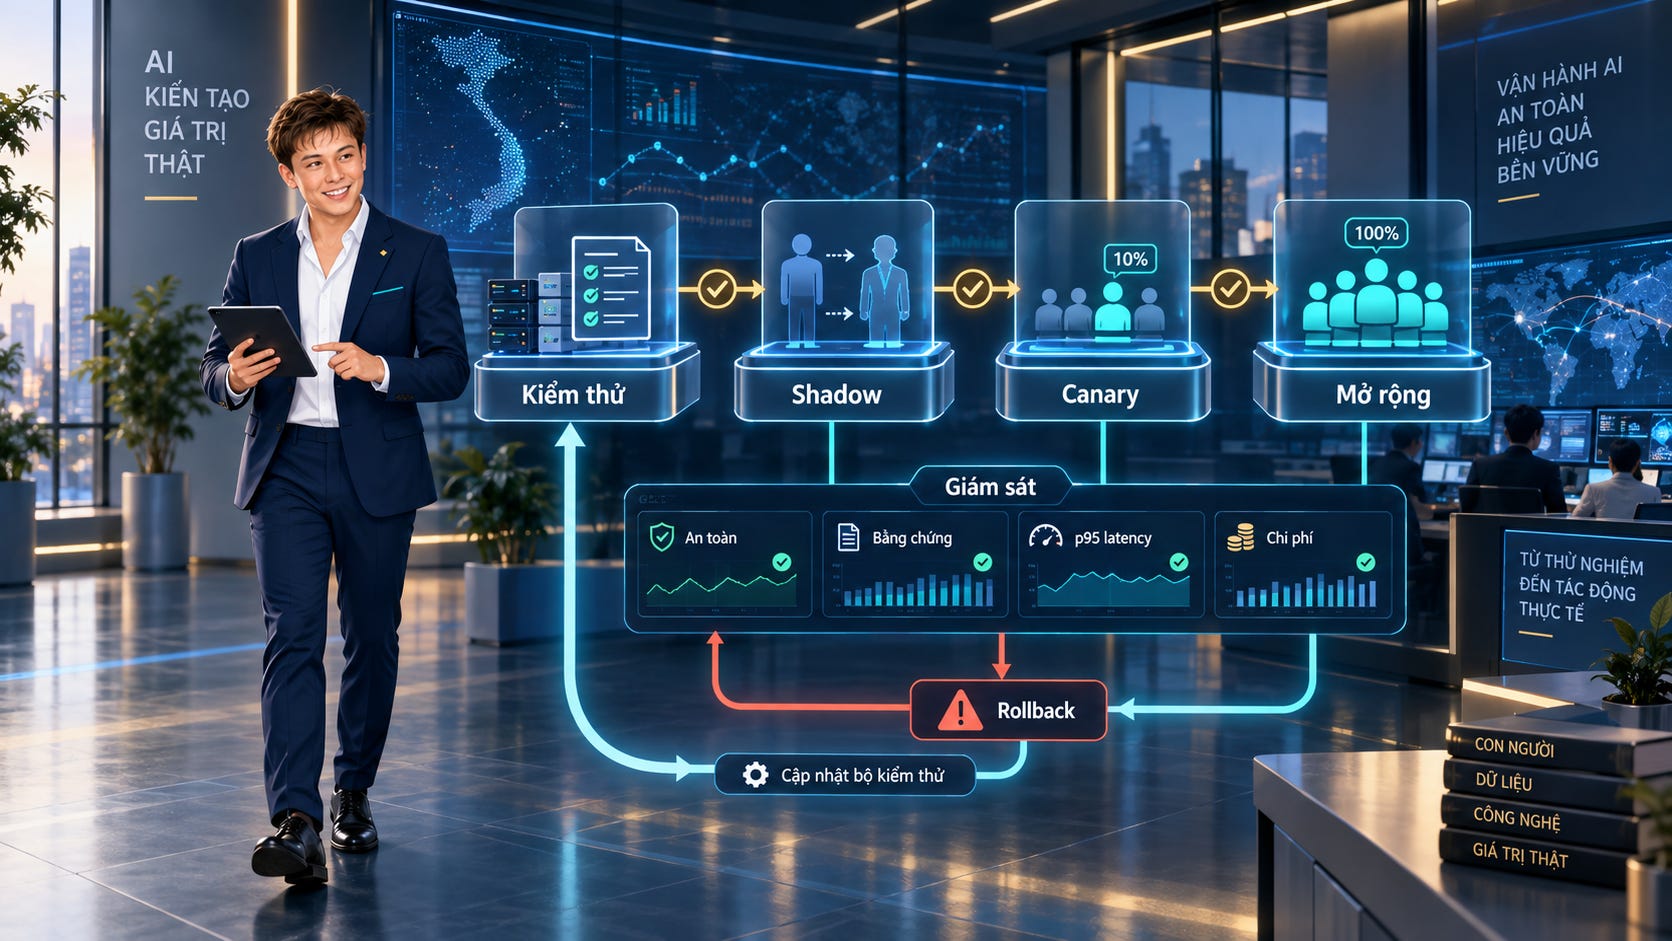
Canary gate nên quan sát đồng thời bốn chiều:
vi phạm an toàn theo lát cắt;
tuyên bố thiếu bằng chứng;
tỷ lệ lỗi công cụ và retrieval;
p95 latency cùng chi phí trên mỗi request.
Ngưỡng rollback phải được thống nhất trước khi phát hành. Trong sự cố, đội ngũ không nên mất thời gian tranh luận xem “đã đủ tệ để quay lui chưa”.
8. Blueprint triển khai trong 90 ngày
Doanh nghiệp có thể bắt đầu theo ba chặng thay vì cố xây một nền tảng hoàn hảo ngay lập tức.
0–30 ngày: Làm cho thất bại trở nên nhìn thấy được
Vẽ lại inference pipeline hiện tại.
Xác định 3–5 intent quan trọng nhất và hai lát cắt rủi ro cao.
Chuẩn hóa input schema và output contract.
Ghi log prompt version, retrieval document ID, tool status và model version.
Đặt token, timeout và retry budget.
Kết quả cần đạt không phải “AI thông minh hơn”, mà là mỗi lỗi có thể truy về đúng bước.
31–60 ngày: Biến chính sách thành cổng máy thực thi được
Xây ánh xạ claim–evidence.
Thêm hard blocker cho tuyên bố nhạy cảm.
Tạo fallback an toàn cho tool timeout và dữ liệu thiếu.
Chạy test lặp để đo decision stability.
Tách metric retrieval, generation và tool execution.
Đến đây, hệ thống bắt đầu thất bại có kiểm soát thay vì thất bại một cách thuyết phục.
61–90 ngày: Khép vòng vận hành
Thiết lập lấy mẫu runtime theo rủi ro.
Hiệu chuẩn judge với đánh giá con người.
Viết runbook cho từng cảnh báo.
Triển khai shadow và canary.
Buộc mọi incident tạo ra test case cùng tiêu chí ngăn tái diễn.
Sau 90 ngày, giá trị lớn nhất là năng lực thay đổi có kiểm soát. Đội ngũ có thể nâng model, sửa prompt hay thay nguồn tri thức mà vẫn biết chất lượng đã đổi ở đâu, rủi ro nào tăng và khi nào cần rollback.
9. Checklist dành cho lãnh đạo và kiến trúc sư giải pháp
Trước khi phê duyệt một trợ lý AI đi vào production, hãy hỏi:
Chúng ta đang đánh giá model hay toàn bộ pipeline?
Mỗi request có truy được prompt, model, policy và retrieval version không?
Tuyên bố nào bắt buộc phải có bằng chứng thực thi?
Khi tool lỗi, hệ thống fallback như thế nào?
Output contract được kiểm tra trước hay sau khi nội dung đến người dùng?
Retry có giới hạn không?
Metric an toàn có được phân tách theo intent và severity không?
p95 latency và chi phí trên request có ngân sách không?
Điều kiện rollback đã được viết trước khi canary chưa?
Mỗi incident có trở thành regression test không?
Nếu chưa trả lời được các câu hỏi này, tổ chức chưa sở hữu một hệ thống AI production. Tổ chức mới chỉ sở hữu một mô hình đang được gọi qua API.
Kết luận
LLM có thể tạo ra ngôn ngữ rất thuyết phục. Nhưng doanh nghiệp cần nhiều hơn khả năng tạo câu: cần bằng chứng, giới hạn, khả năng truy vết và một cơ chế phản ứng khi thực tế thay đổi.
Kiến trúc inference có kiểm soát không cố loại bỏ hoàn toàn sai sót. Nó làm ba việc thực tế hơn:
ngăn những sai sót đắt giá nhất trước khi đến người dùng;
khiến phần còn lại có thể quan sát và điều tra;
biến mỗi sự cố thành một cải tiến lâu dài cho hệ thống.
Đó là bước chuyển quan trọng từ AI trả lời hay sang AI vận hành đáng tin cậy — và cũng là ranh giới giữa một bản demo hấp dẫn với một năng lực doanh nghiệp thực sự.