

Kiến trúc kiểm soát ở thời điểm suy luận giúp doanh nghiệp biến một mô hình thị giác–ngôn ngữ đã qua kiểm thử thành một hệ thống biết chấp nhận, từ chối, chuyển người duyệt và tự bảo vệ trước dữ liệu thực tế.
Một mô hình thị giác–ngôn ngữ (Vision-Language Model, VLM) có thể đạt điểm rất cao trên bộ dữ liệu kiểm thử, đọc đúng hóa đơn mẫu và trả về JSON hợp lệ. Nhưng ngay khi đi vào vận hành, nó sẽ gặp ảnh chụp nghiêng từ điện thoại, bản scan thiếu nét, biểu mẫu của nhà cung cấp mới, chữ cực nhỏ ở chân trang và cả những chỉ dẫn độc hại được giấu trong tài liệu.
Đó là khoảng cách giữa một mô hình đã vượt qua kỳ thi và một hệ thống đủ tin cậy để tham gia quy trình kinh doanh. Khoảng cách này cũng xuất hiện với hệ thống ngôn ngữ: đưa LLM vào production không phải chỉ là gọi mô hình, mà là xây một hệ thống kiểm soát.
Ở môi trường kiểm thử, đội ngũ có nhãn chuẩn, bounding box và tập tình huống đã biết. Ở production, mỗi tài liệu mới gần như không có “đáp án” đi kèm. Tuy vậy, hệ thống kế toán vẫn cần quyết định: ghi nhận số tiền này, giữ lại để kiểm tra hay từ chối toàn bộ giao dịch?
Vì thế, bài toán trọng tâm không còn là “accuracy của model là bao nhiêu?”. Câu hỏi đúng hơn là:
Với từng trường dữ liệu và từng yêu cầu đang chạy thật, hệ thống có đủ bằng chứng để cho phép kết quả đi tiếp hay không?
Một thay đổi tư duy: chất lượng mô hình không đồng nghĩa với độ tin cậy của hệ thống
Khi doanh nghiệp dùng VLM để đọc hóa đơn, phiếu xuất kho, hồ sơ bảo hiểm hoặc ảnh kiểm định, sai sót không dừng ở một câu trả lời thiếu chính xác. Một con số không được đối chiếu có thể trở thành khoản thanh toán sai. Một vị trí lỗi không được định vị đúng có thể tạo ra kết luận kiểm định nhầm. Một hướng dẫn độc hại trong ảnh có thể khiến mô hình bỏ qua chính sách.
Có năm nguyên tắc nên được coi là “lan can” của kiến trúc:
Ảnh người dùng gửi chưa chắc là ảnh encoder thực sự nhìn thấy. Resize, crop, deskew, nén và chia tile đều có thể làm mất chi tiết.
Đúng cấu trúc chưa chắc đúng bằng chứng. JSON hợp lệ vẫn có thể chứa một con số bịa đặt.
Confidence không phải là evidence. Mô hình tự tin không chứng minh nội dung xuất hiện trong ảnh.
Lỗi an toàn không được bù bằng chất lượng trung bình cao. Một ca prompt injection thành công vẫn là một blocker.
Mỗi chỉ số quan trọng phải gắn với một hành động đã định trước. Nếu dashboard đỏ nhưng không ai biết phải làm gì, đó chỉ là trang trí.
Điểm đáng lưu ý là các nguyên tắc này không yêu cầu doanh nghiệp phải sở hữu model tốt nhất. Chúng yêu cầu một kiến trúc có thể quan sát, kiểm chứng và giới hạn hậu quả khi model sai. Vì vậy, trước khi chọn công nghệ, đội ngũ vẫn cần hiểu đúng bài toán AI và xác định kết quả có thể đo lường.
Năm lớp kiểm soát cho một VLM chạy thật
Thay vì đặt toàn bộ niềm tin vào một lần sinh kết quả, hãy tổ chức luồng suy luận thành năm lớp. Mỗi lớp có một nhiệm vụ, một tập telemetry và một quyết định rõ ràng.
Lớp 1: Kiểm tra đầu vào trước khi model nhìn thấy pixel
Phần lớn sự cố thị giác bắt đầu từ trước bước inference. Lớp intake cần xử lý một cách xác định:
định dạng, codec, dung lượng và số trang có hợp lệ không;
độ phân giải, DPI, màu sắc, độ mờ, độ sáng và độ nghiêng có nằm trong ngưỡng không;
metadata có bất thường không;
tài liệu có chứa chỉ dẫn đáng ngờ hướng đến model không;
nếu chất lượng giảm, hệ thống sẽ chấp nhận, gắn cờ, chuyển người duyệt hay từ chối.
Đừng gửi một file “có vẻ đọc được” vào model rồi hy vọng model tự xoay xở. Intake policy nên trả về reason code cụ thể như unsupported_codec, blur_exceeded, dpi_below_threshold hoặc embedded_instruction_detected. Reason code vừa giúp vận hành, vừa tạo dữ liệu để cải tiến nguồn thu nhận.
Lớp 2: Ghi lại chính xác những gì encoder đã nhận
Giữa ảnh gốc và tensor đầu vào có thể là cả một chuỗi biến đổi. Khi một trường dữ liệu bị đọc sai, việc chỉ lưu ảnh gốc không đủ để điều tra.
Execution trace nên ghi:
phiên bản pipeline tiền xử lý;
thứ tự trang và vai trò của từng ảnh;
quy tắc resize, crop, deskew, tile;
hệ tọa độ trước và sau biến đổi;
hash của ảnh sau tiền xử lý;
phiên bản OCR, layout detector và vision encoder.
Hash sau tiền xử lý là một chi tiết nhỏ nhưng có giá trị lớn. Nó trả lời câu hỏi căn bản trong incident review: chúng ta đang phân tích đúng hình ảnh mà model từng thấy hay chỉ đang nhìn lại file ban đầu?
Lớp 3: Buộc đầu ra mang theo hợp đồng và bằng chứng
Schema tốt không chỉ mô tả vendor, invoice_date, subtotal, tax và total. Với mỗi trường có tác động kinh doanh, nó nên yêu cầu thêm:
giá trị được trích xuất;
vùng ảnh làm bằng chứng;
confidence đã hiệu chuẩn;
nguồn bằng chứng;
mức độ đồng thuận với OCR hoặc detector độc lập;
quyết định
accept,abstainhayescalate.
Sau khi model sinh kết quả, validator cần chạy theo ba tầng:
Cấu trúc: đúng kiểu dữ liệu, đủ trường, parse được.
Hình học: bounding box nằm trong kích thước ảnh sau tiền xử lý, không đảo tọa độ, không trỏ ra ngoài trang.
Nhất quán nghiệp vụ: subtotal cộng thuế có khớp total trong sai số cho phép; ngày tháng hợp lệ; dòng hàng có quan hệ hợp lý với tổng tiền.
Chỉ sửa tự động những lỗi cấu trúc có phạm vi hẹp. Nếu vùng bằng chứng sai hoặc phép tính mâu thuẫn, việc “prompt model sửa lại” có thể chỉ làm câu trả lời nghe hợp lý hơn mà không làm bằng chứng tốt hơn.
Lớp 4: Cổng evidence-binding trước hệ thống nghiệp vụ
Đây là lớp phân biệt demo với production.
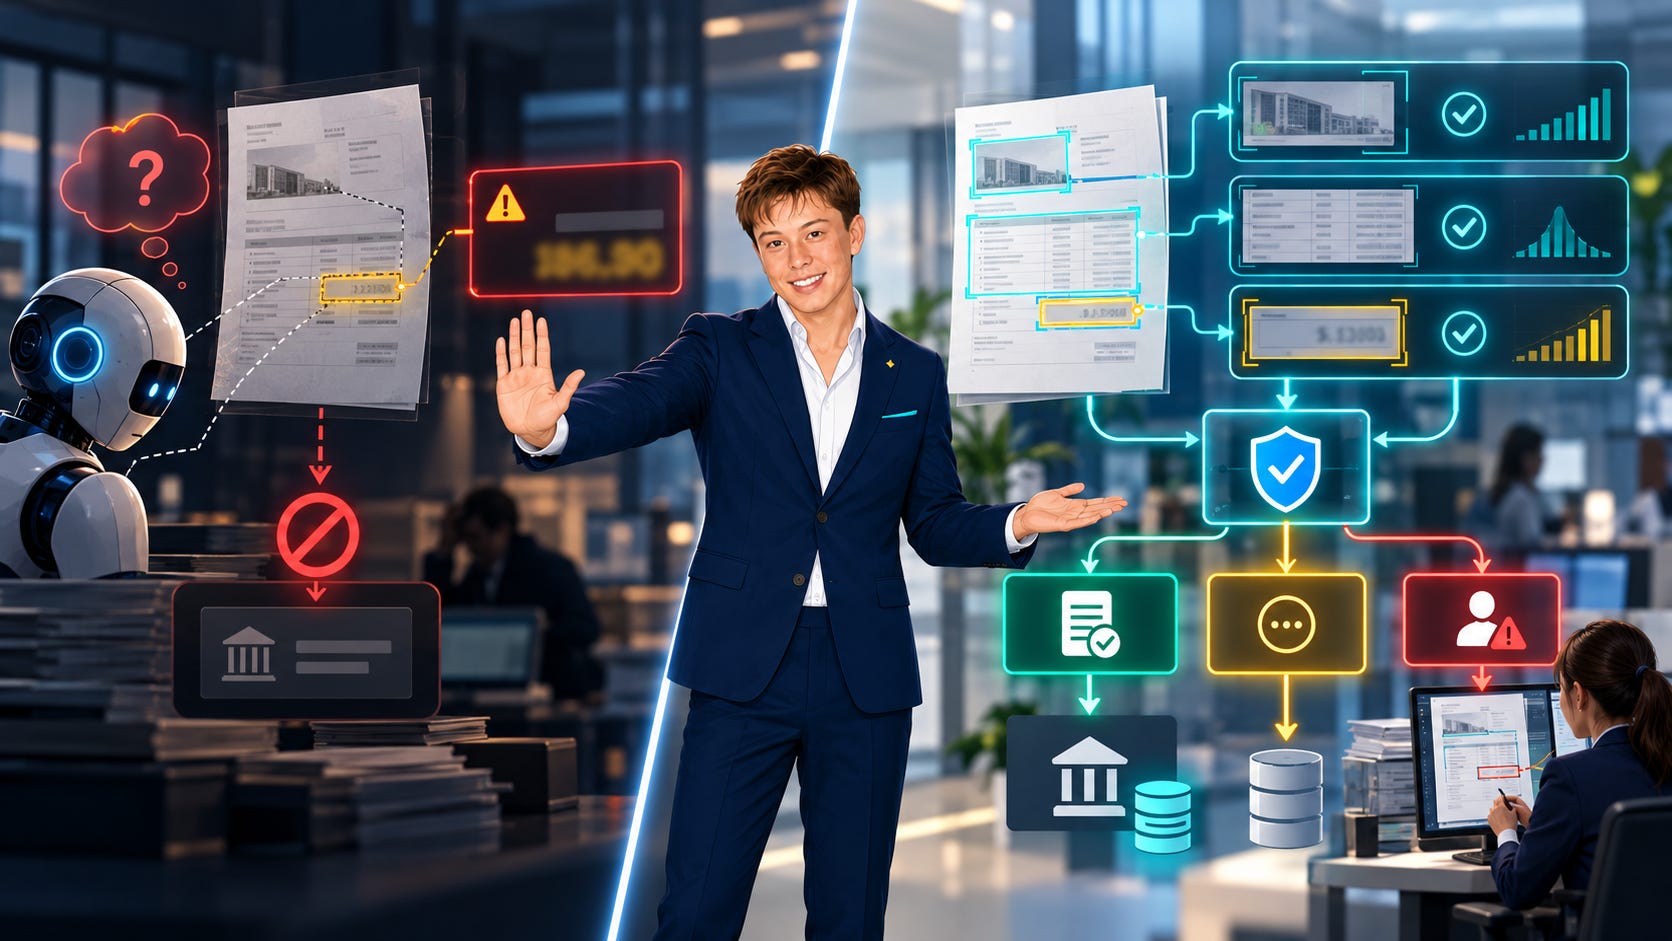
Một trường total = 128.500.000 không được phép đi thẳng vào hệ thống công nợ chỉ vì API trả về thành công. Với trường rủi ro cao, cổng bằng chứng có thể yêu cầu đồng thời:
bounding box của model bao phủ đúng vùng chứa tổng tiền;
OCR trên chính vùng đó trả về giá trị tương thích;
confidence vượt ngưỡng đã hiệu chuẩn cho loại tài liệu và chất lượng ảnh tương ứng;
kiểm tra số học không phát hiện mâu thuẫn.
Nếu thiếu một điều kiện, hệ thống không đoán tiếp. Nó abstain và chuyển sang luồng xử lý phù hợp: yêu cầu ảnh tốt hơn, chạy pipeline dự phòng hoặc đưa cho người duyệt.
Đây cũng là nơi cần phân tầng mức độ quan trọng. Sai tên mô tả hàng hóa có thể chỉ cần gắn cờ. Sai số tài khoản, tổng tiền hoặc kết luận y khoa phải bị chặn. Cùng một model, nhưng chính sách chấp nhận phải khác nhau theo hậu quả của từng trường dữ liệu.
Lớp 5: Giám sát, canary và rollback theo từng lát cắt
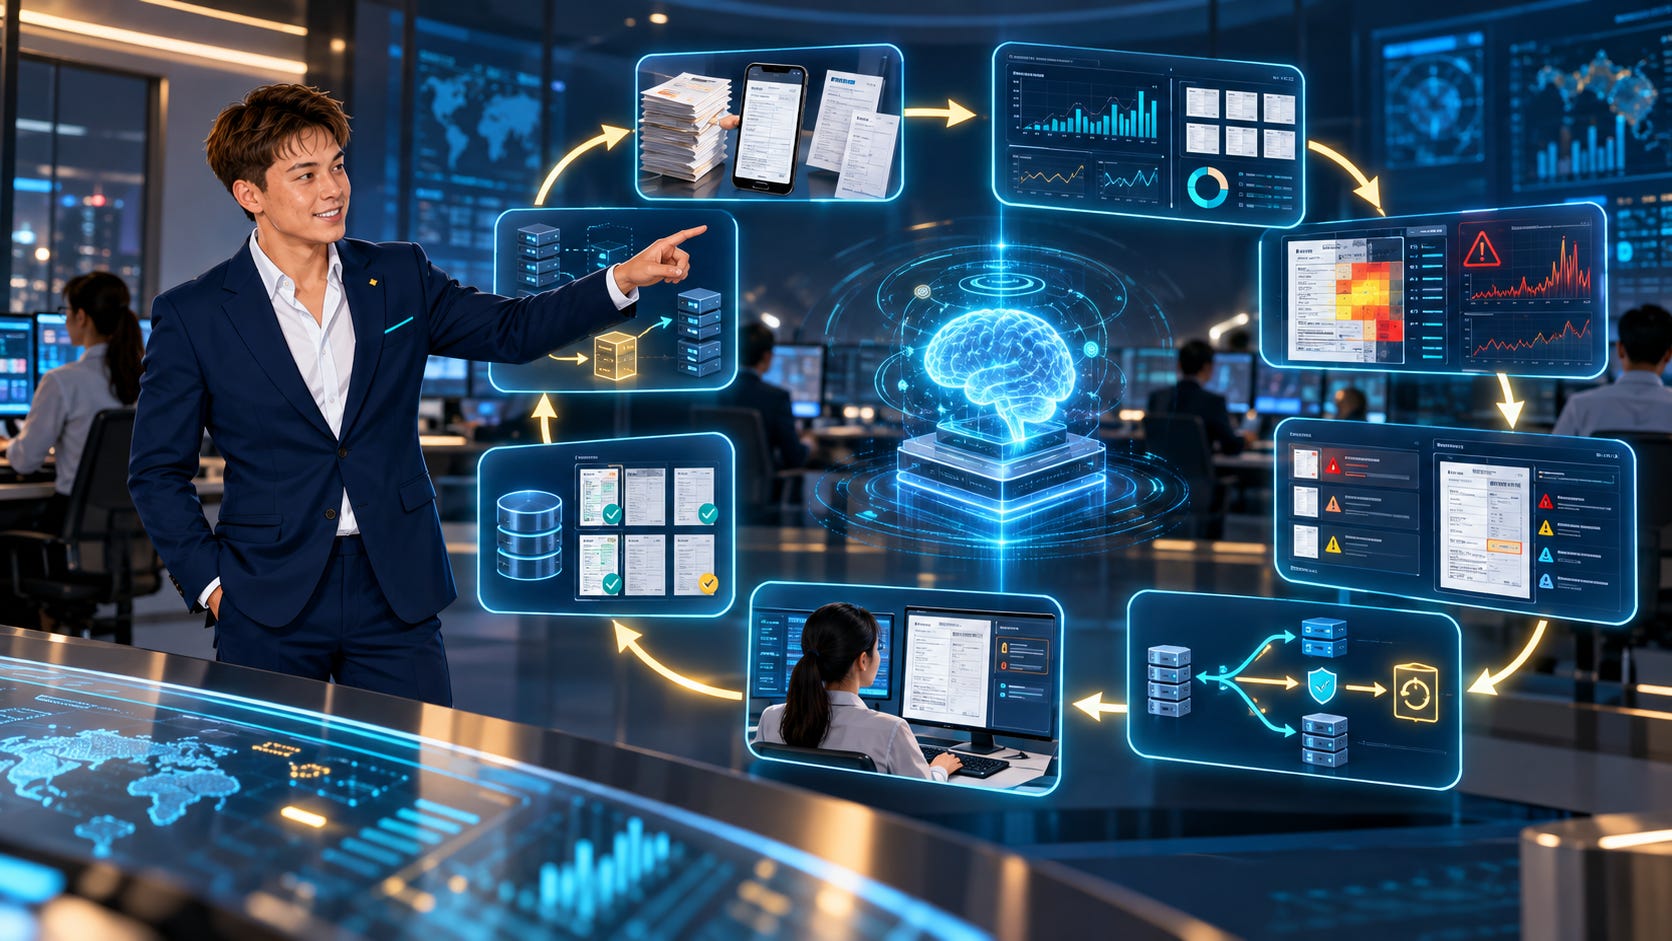
Một tỷ lệ lỗi chung thường che giấu nơi hệ thống đang hỏng. Doanh nghiệp cần theo dõi theo lát cắt:
nguồn chụp: scanner, điện thoại, ảnh từ ứng dụng đối tác;
loại tài liệu và nhà cung cấp;
mức phân giải, blur, skew, độ dày chữ;
phiên bản encoder, prompt, OCR và preprocessing;
các trường nghiệp vụ cấp một;
tài liệu có mật độ chỉ dẫn nhúng cao.
Các chỉ số “chịu lực” có thể gồm tỷ lệ claim quan trọng thiếu bằng chứng, tỷ lệ vi phạm evidence-binding, lỗi safety canary, tỷ lệ hệ thống downstream từ chối, p95/p99 latency và chi phí trên mỗi tài liệu. Chỉ số chẩn đoán như drift layout, drift OCR hay reviewer disagreement giải thích vì sao chỉ số chịu lực thay đổi.
Mỗi ngưỡng phải nối với một playbook: giảm lưu lượng canary, chuyển một lát cắt sang human review, rollback prompt, rollback encoder hoặc mở incident. Nếu safety canary thất bại, rollback nên là phản ứng tức thời, không chờ chất lượng tổng thể “bù lại”.
Luồng quyết định thực tế: accept, abstain, escalate hay rollback
Một kiến trúc VLM đáng tin không cố trả lời mọi yêu cầu. Nó biết giới hạn phạm vi tự động hóa.
Hãy hình dung hóa đơn từ một chi nhánh mới đi qua pipeline:
Intake phát hiện độ phân giải thấp hơn phân phối quen thuộc nhưng vẫn trên ngưỡng tối thiểu, nên gắn cờ
degraded_input.Pipeline deskew và upsample, ghi lại phiên bản biến đổi cùng hash ảnh mới.
Model trả JSON hợp lệ, nhưng bounding box của trường tổng tiền lệch khỏi nhãn “Tổng cộng”.
OCR vùng do model chỉ ra không đồng thuận với giá trị sinh ra.
Evidence gate không cho phép ghi dữ liệu vào hệ thống kế toán và chuyển riêng trường tổng tiền cho người duyệt.
Dashboard ghi nhận localization correctness giảm ở lát cắt của chi nhánh mới.
Khi xu hướng vượt ngưỡng, hệ thống tự giảm automation rate của lát cắt đó và mở incident.
Không có bước nào trong chuỗi này cố “chứng minh model thông minh”. Mọi bước chỉ trả lời ba câu hỏi vận hành: có đủ bằng chứng không, hậu quả nếu sai là gì, và hành động an toàn tiếp theo là gì?
Confidence là tín hiệu, không phải giấy thông hành
Nhiều hệ thống dùng một ngưỡng confidence duy nhất cho mọi loại tài liệu. Cách này dễ triển khai nhưng dễ tạo cảm giác an toàn giả.
Confidence phải được hiệu chuẩn theo lát cắt và theo mức độ quan trọng. Một score 0,92 trên ảnh scan rõ có thể mang ý nghĩa khác 0,92 trên ảnh chụp điện thoại bị lóa. Confidence cho trường description cũng không nên có cùng chính sách với bank_account.
Ngoài confidence, groundedness cần được tách thành ít nhất ba câu hỏi:
Coverage: model có quan sát đủ vùng liên quan không?
Faithfulness: giá trị trả về có thực sự được hỗ trợ bởi nội dung ảnh không?
Localization correctness: vùng được viện dẫn có đúng vị trí chứa bằng chứng không?
Tách ba chiều này giúp chẩn đoán chính xác. Coverage kém có thể đến từ tiling. Faithfulness kém có thể đến từ generation. Localization sai có thể đến từ chuyển đổi hệ tọa độ. Gộp tất cả thành một điểm “accuracy” sẽ khiến đội ngũ sửa sai thành phần.
Human review không phải thất bại của tự động hóa
Nếu coi mọi trường hợp chuyển người duyệt là một lỗi, đội sản phẩm sẽ có động lực nới ngưỡng để tăng automation rate. Kết quả là rủi ro âm thầm chuyển sang hệ thống nghiệp vụ.
Human review nên được thiết kế như một tầng kiểm soát có chủ đích. Đây cũng là nguyên tắc chung khi đưa AI agent vào GitHub: quyền hạn phải hẹp và luôn có đường lui rõ ràng cho con người:
ưu tiên mẫu có confidence thấp hoặc sát ngưỡng;
tăng tỷ lệ lấy mẫu cho nguồn chụp mới và lát cắt đang drift;
luôn xem xét trường có hậu quả cao khi các nguồn bằng chứng bất đồng;
lấy mẫu ngẫu nhiên một phần kết quả “tự tin cao” để phát hiện blind spot;
đo reviewer disagreement để biết hướng dẫn đánh giá có đủ rõ hay không.
Các case đã duyệt phải quay lại thành regression data. Một kiểu scanner mới có thể trở thành một slice trong stress suite. Một mẫu prompt injection mới phải được thêm vào safety canary. Production không chỉ là nơi model phục vụ; đó còn là nơi hệ thống học được những thất bại mà bộ kiểm thử ban đầu chưa biết.
Năm budget dial cần chốt trước khi mở lưu lượng
Độ tin cậy không thể tách khỏi chi phí và độ trễ. VLM có thể tiêu tốn mạnh khi ảnh lớn, chia nhiều tile, retry nhiều lần hoặc gọi grader trên mọi request. Ít nhất năm “núm điều chỉnh” nên được khai báo:
ngân sách token và image-token trên mỗi yêu cầu;
số lần repair hoặc retry tối đa;
timeout riêng cho encoder, generation và grader;
tỷ lệ lấy mẫu cho grader và human review;
error budget theo cửa sổ thời gian.
Đây không phải cấu hình kỹ thuật thuần túy. Chúng quyết định chi phí trên tài liệu, tải của người duyệt và mức độ rủi ro doanh nghiệp chấp nhận. Khi tăng độ phân giải để cải thiện OCR, đội ngũ phải quan sát đồng thời latency, cost và groundedness. Nếu chỉ tối ưu một biến, hệ thống dễ chuyển lỗi từ chất lượng sang kinh tế vận hành.
Checklist triển khai cho đội kiến trúc
Trước khi cho VLM ghi dữ liệu vào hệ thống nghiệp vụ, hãy bảo đảm có câu trả lời rõ cho các câu hỏi sau:
Đầu vào nào bị từ chối, đầu vào nào được xử lý suy giảm và reason code là gì?
Có thể tái dựng chính xác ảnh sau tiền xử lý mà encoder đã nhận không?
Mỗi trường quan trọng có vùng bằng chứng và nguồn kiểm chứng độc lập không?
Validator phân biệt lỗi cấu trúc với lỗi groundedness như thế nào?
Khi model không đủ bằng chứng, đường
abstaindẫn đến đâu?Ngưỡng có được hiệu chuẩn theo trường dữ liệu và lát cắt hay chỉ dùng một con số chung?
Safety failure có chặn rollout bất kể quality score hay không?
Dashboard nào là load-bearing, và ai là owner của từng hành động?
Có shadow, canary, điều kiện promotion và tiêu chí rollback cụ thể không?
Incident đã đóng có trở thành regression test cho vòng phát hành sau không?
Nếu một câu hỏi chưa có chủ sở hữu hoặc hành động, kiến trúc vẫn còn một khoảng trống kiểm soát.
Kết luận: Mục tiêu không phải là model luôn trả lời
Một hệ thống VLM production-grade không được định nghĩa bởi khả năng trả lời mọi ảnh. Nó được định nghĩa bởi khả năng chỉ cho phép những kết quả đủ bằng chứng đi tiếp.
Đội ngũ nên đo thành công bằng chất lượng của quyết định tại từng request: chấp nhận khi đủ căn cứ, từ chối khi đầu vào không an toàn, abstain khi bằng chứng yếu, chuyển người duyệt khi hậu quả cao và rollback khi tín hiệu production vượt ngưỡng.
Khi đó, mô hình chỉ là một thành phần trong hệ thống. Độ tin cậy đến từ toàn bộ kiến trúc: intake xác định, trace tái dựng được, output contract có bằng chứng, evidence gate bảo vệ downstream, monitoring theo lát cắt và vòng lặp incident biến sai sót thành năng lực mới.
Đó là cách doanh nghiệp đi từ một VLM “trả lời có vẻ đúng” đến một năng lực AI có thể chịu trách nhiệm trong vận hành thật.
Một VLM đáng tin không phải là hệ thống luôn trả lời, mà là hệ thống biết khi nào bằng chứng chưa đủ để hành động. Bạn đang kiểm soát bước nào tốt nhất: đầu vào, evidence-binding hay monitoring theo lát cắt?