

RAG, in-context learning hay fine-tuning không phải ba “món công nghệ” để chọn theo xu hướng. Đó là ba lớp can thiệp khác nhau — vào tri thức, chỉ dẫn và hành vi — cần được đặt trong một kiến trúc có kiểm chứng.
Một doanh nghiệp đưa trợ lý AI vào vận hành. Sau vài tuần thử nghiệm, hệ thống trả lời trôi chảy nhưng nhầm chính sách nội bộ. Đội dự án đề xuất fine-tune để mô hình “biết nghiệp vụ hơn”. Một nhóm khác muốn dựng kho vector. Nhóm thứ ba tiếp tục kéo dài prompt.
Cả ba hướng đều có thể đúng. Nhưng nếu chưa xác định hệ thống đang thiếu tri thức, thiếu chỉ dẫn hay thiếu một hành vi ổn định, mọi khoản đầu tư tiếp theo chỉ là tối ưu sai lớp.
Đây là điểm dễ bị bỏ qua khi doanh nghiệp chuyển từ chatbot thử nghiệm sang AI agent thực sự. Mô hình ngôn ngữ tổng quát là một “bộ não” giàu năng lực, nhưng agent doanh nghiệp phải hành động như một chuyên gia có vai trò rõ ràng: hiểu từ vựng riêng, truy cập dữ liệu được phép, tuân thủ quy trình, biết khi nào phải hỏi lại và để lại bằng chứng cho quyết định. Bởi vậy, chọn một LLM “agent-ready” thực chất là bài toán thiết kế cả hệ thần kinh, không phải mua bộ não lớn nhất.
Vì thế, câu hỏi kiến trúc không nên là “RAG hay fine-tuning tốt hơn?”. Câu hỏi đúng hơn là:
Cần thay đổi điều gì trong hệ thống để đầu ra đúng hơn, ổn định hơn và có thể kiểm chứng — với chi phí thấp nhất?
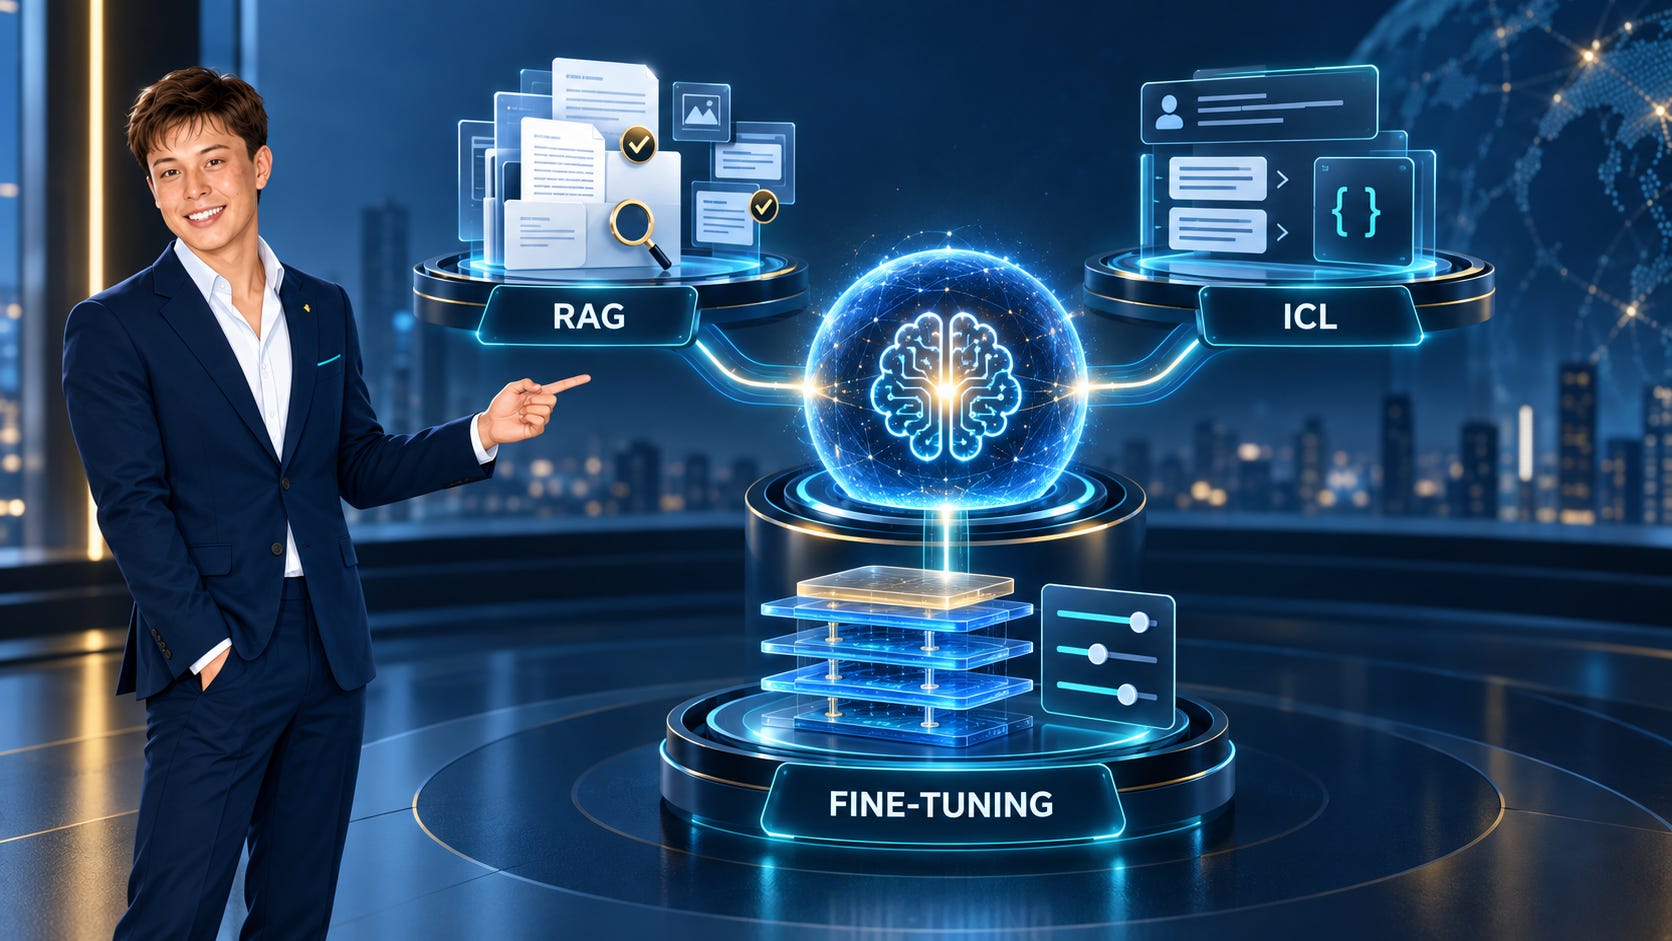
Hình 1 — Ba lớp thích nghi tác động vào ba đối tượng khác nhau: chỉ dẫn, tri thức và hành vi.
Ba lớp thích nghi, ba loại vấn đề
Có thể hình dung một agent doanh nghiệp gồm bốn lớp: mô hình nền, ngữ cảnh được đưa vào, công cụ được phép sử dụng và cơ chế kiểm soát đầu ra. RAG, in-context learning (ICL) và fine-tuning tác động vào những phần khác nhau của cấu trúc này.
RAG: đưa đúng tri thức vào đúng thời điểm
Retrieval-Augmented Generation (RAG) truy xuất thông tin từ nguồn bên ngoài rồi đưa phần liên quan vào ngữ cảnh trước khi mô hình tạo câu trả lời. Mô hình không cần “nhớ” toàn bộ sổ tay nhân sự, danh mục sản phẩm hay quy định tuân thủ. Nó chỉ cần nhận được đúng đoạn tài liệu khi xử lý một yêu cầu cụ thể.
RAG phù hợp khi:
kiến thức thay đổi thường xuyên;
dữ liệu thuộc nội bộ doanh nghiệp;
câu trả lời cần dẫn nguồn;
phạm vi tài liệu lớn hơn cửa sổ ngữ cảnh;
quyền truy cập phụ thuộc vai trò người dùng.
Giá trị lớn nhất của RAG không nằm ở vector database. Nó nằm ở khả năng quản trị nguồn sự thật: tài liệu nào có hiệu lực, phiên bản nào mới nhất, ai được xem và câu trả lời dựa trên đoạn nào.
Một hệ thống RAG yếu thường không thất bại ở bước “generate”, mà ở trước đó: tài liệu chưa được làm sạch, đơn vị chia đoạn không hợp lý, metadata thiếu, truy vấn không được viết lại, hoặc bộ xếp hạng đưa nội dung gần nghĩa nhưng sai hiệu lực lên đầu.
In-context learning: dạy nhiệm vụ ngay trong phiên làm việc
ICL giúp mô hình suy ra cách thực hiện nhiệm vụ từ chỉ dẫn và một số ví dụ nằm ngay trong prompt. Trọng số mô hình không đổi. Khi ngữ cảnh kết thúc, sự “học” này cũng không được lưu lại.
ICL phù hợp khi doanh nghiệp cần:
áp một định dạng đầu ra nhất quán;
xử lý một tác vụ mới hoặc thay đổi nhanh;
minh họa sắc thái phân loại bằng vài ví dụ;
thử nghiệm tiêu chí trước khi đầu tư sâu;
cá nhân hóa hành vi theo từng phiên.
Ví dụ, thay vì chỉ yêu cầu “phân tích phản hồi khách hàng”, ta cung cấp hai hoặc ba mẫu đầu vào–đầu ra thể hiện rõ cách tách tính năng, gán sắc thái và xuất JSON. Mô hình có thể bắt chước cấu trúc đó ngay lập tức.
Điểm mạnh của ICL là tốc độ. Điểm yếu cũng chính là ngữ cảnh: prompt dài làm tăng chi phí và độ trễ; ví dụ không đại diện dễ làm lệch kết quả; những gì mô hình làm đúng trong một bộ mẫu chưa chắc ổn định trên toàn bộ phân phối dữ liệu thật.
Fine-tuning: làm hành vi chuyên biệt trở thành mặc định
Fine-tuning điều chỉnh tham số mô hình bằng dữ liệu huấn luyện để tạo ra một hành vi bền vững hơn. Kỹ thuật này phù hợp khi yêu cầu không chỉ là “biết thêm một tài liệu”, mà là làm một việc lặp đi lặp lại theo một chuẩn riêng.
Các trường hợp đáng cân nhắc gồm:
phong cách hoặc cấu trúc đầu ra phải ổn định ở quy mô lớn;
tác vụ chuyên môn có nhiều mẫu huấn luyện chất lượng cao;
prompt đã quá dài vì phải lặp lại cùng một chỉ dẫn;
mô hình nhỏ chuyên biệt có thể thay mô hình lớn để giảm độ trễ và chi phí;
agent cần thành thạo một kỹ năng cụ thể, như phân loại ý định hay sinh lời gọi công cụ theo schema.
Fine-tuning không phải cách tối ưu để “nạp” một bảng giá đổi mỗi tuần. Nó cũng không tự tạo ra tính đúng đắn. Nếu dữ liệu huấn luyện chứa quyết định thiếu nhất quán, mô hình chỉ học sự thiếu nhất quán ấy một cách hiệu quả hơn.
Các phương pháp tinh chỉnh hiệu quả tham số như LoRA hay adapter có thể giảm chi phí so với cập nhật toàn bộ mô hình. Tuy nhiên, phần khó nhất vẫn là dữ liệu: định nghĩa chuẩn, thu thập mẫu, loại lỗi, chia tập đánh giá và quản lý phiên bản.
Ma trận chọn phương án: bắt đầu từ độ biến động và loại sai số
Một cách thực dụng là đặt yêu cầu lên hai trục:
Tri thức thay đổi nhanh hay chậm?
Điều cần ổn định là dữ kiện hay hành vi?
Nhu cầu chính
RAG
ICL
Fine-tuning
Chính sách, giá, dữ liệu mới cập nhật
Rất phù hợp
Hỗ trợ
Không nên là lớp chính
Cần dẫn nguồn và truy vết
Rất phù hợp
Hạn chế
Hạn chế
Định dạng đầu ra theo vài ví dụ
Có thể hỗ trợ
Rất phù hợp
Phù hợp khi đã ổn định
Hành vi chuyên biệt lặp lại ở quy mô lớn
Hỗ trợ ngữ cảnh
Dùng để thử nghiệm
Rất phù hợp
Thay đổi yêu cầu trong ngày hoặc theo phiên
Phù hợp
Rất phù hợp
Kém linh hoạt
Tối ưu mô hình nhỏ cho một kỹ năng
Không giải quyết trực tiếp
Không giải quyết trực tiếp
Rất phù hợp
Tốc độ triển khai ban đầu
Trung bình
Nhanh
Chậm hơn
Yêu cầu về dữ liệu huấn luyện
Không
Không
Cao
Bảng này gợi ra một nguyên tắc đơn giản:
Nếu thiếu dữ kiện, truy xuất. Nếu thiếu cách làm, đưa ví dụ. Nếu hành vi đã rõ và lặp lại đủ nhiều, mới cân nhắc tinh chỉnh.
Trong thực tế, ba kỹ thuật thường bổ sung cho nhau. Một agent hỗ trợ khách hàng có thể dùng fine-tuning để nhận diện ý định và giao tiếp đúng giọng thương hiệu, RAG để lấy chính sách hiện hành, ICL để đáp ứng một chiến dịch mới, rồi lớp grounding để kiểm tra rằng câu trả lời thực sự được nguồn hỗ trợ.
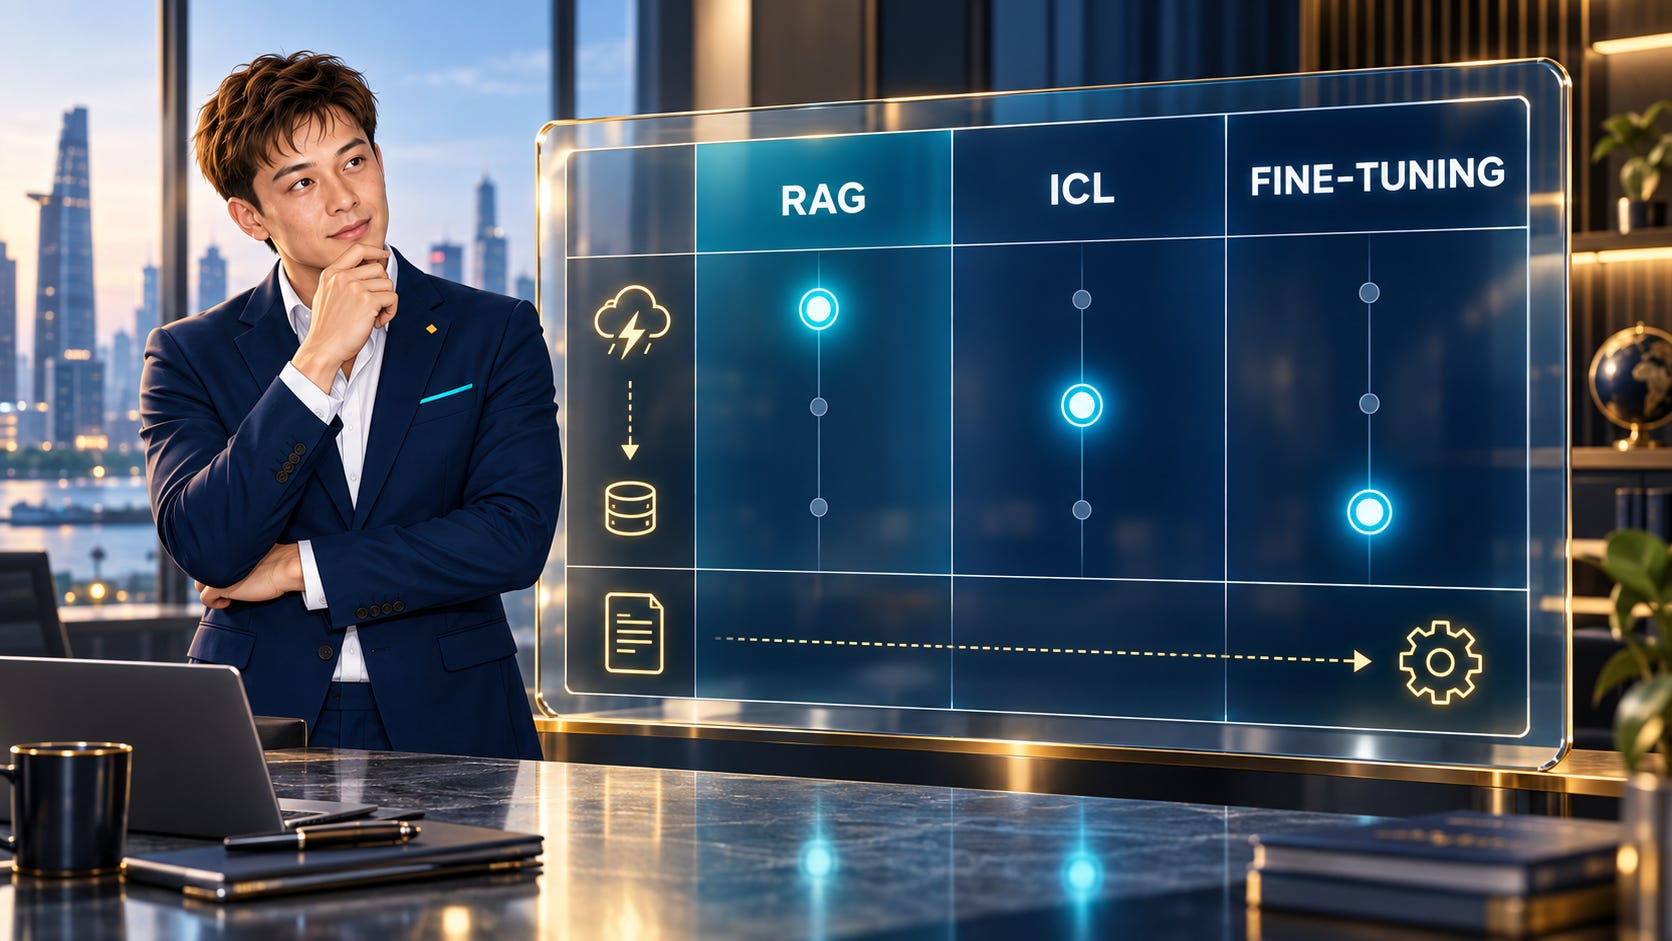
Hình 2 — Chọn kỹ thuật theo loại vấn đề, không theo độ “hot” của công nghệ.
Đừng biến một mô hình thành cả doanh nghiệp
Khi số lượng quy trình tăng lên, một agent duy nhất với prompt khổng lồ sẽ sớm trở thành nút thắt. Nó phải hiểu quá nhiều vai trò, nhìn thấy quá nhiều dữ liệu và lựa chọn giữa quá nhiều công cụ. Khi có lỗi, đội vận hành khó xác định lỗi đến từ truy xuất, lập kế hoạch, gọi công cụ hay phản hồi.
Một kiến trúc phân cấp giải quyết vấn đề theo hướng khác:
Orchestrator nhận mục tiêu, phân rã nhiệm vụ và điều phối;
agent chuyên biệt chịu trách nhiệm cho một miền hẹp như tài chính, pháp chế, bán hàng;
capability đóng gói công cụ, API hoặc quy trình có quyền hạn cụ thể;
callback/guardrail ghi nhận sự kiện, kiểm tra chính sách và chặn hành động rủi ro;
human checkpoint tiếp nhận những trường hợp vượt ngưỡng.
Cấu trúc này cho phép mỗi agent sử dụng một “bộ não” phù hợp. Tác vụ phân loại đơn giản có thể chạy trên mô hình nhỏ; tác vụ lập kế hoạch phức tạp dùng mô hình mạnh hơn; kiểm tra quy tắc có thể hoàn toàn không cần LLM. Tối ưu kiến trúc vì thế không đồng nghĩa dùng mô hình lớn nhất ở mọi điểm.
Quan trọng hơn, ranh giới agent cũng là ranh giới quản trị. Agent tuyển dụng không cần quyền đọc dữ liệu giá vốn. Agent phân tích tài chính không nên tự gửi email cho khách hàng. Mỗi vai trò phải có nguồn dữ liệu, công cụ, ngân sách và cơ chế phê duyệt riêng.
Grounding không phải một câu “hãy trả lời chính xác”
Thích nghi giúp mô hình phù hợp hơn, nhưng không đảm bảo mọi đầu ra đều đáng tin. Grounding — kết nối đầu ra với thông tin có thể kiểm chứng — phải là một luồng vận hành, không phải lời nhắc ở cuối prompt. Đó cũng là lý do đưa LLM vào production cần một hệ thống kiểm soát thay vì chỉ một lời gọi model.
Một thiết kế tối thiểu nên có bốn cơ chế.
1. Dẫn nguồn ở cấp độ khẳng định
Không chỉ liệt kê vài đường dẫn cuối câu trả lời. Hệ thống cần biết khẳng định nào được hỗ trợ bởi đoạn nguồn nào, tài liệu có phiên bản bao nhiêu và còn hiệu lực hay không.
2. Kiểm tra chéo trước hành động
Một câu trả lời sai có thể gây khó chịu; một hành động sai có thể gây tổn thất. Trước khi tạo đơn hàng, duyệt hoàn tiền hay thay đổi cấu hình, agent cần kiểm tra các trường quan trọng với hệ thống nghiệp vụ hoặc một nguồn có thẩm quyền.
3. Thể hiện bất định bằng hành vi
“Confidence score” do mô hình tự nêu không phải bằng chứng tuyệt đối. Doanh nghiệp nên kết hợp nhiều tín hiệu: độ phù hợp truy xuất, mức đồng thuận giữa các nguồn, kết quả kiểm tra schema, quy tắc nghiệp vụ và lịch sử lỗi. Khi tín hiệu yếu, agent phải biết dừng, hỏi thêm hoặc chuyển người.
4. Giảm mơ hồ trước khi lập kế hoạch
“Đặt vé đi Springfield sớm nhất” chưa đủ để hành động. Springfield nào, ngày nào, ngân sách bao nhiêu? Một agent đáng tin không đoán để tạo cảm giác nhanh; nó làm rõ tiền đề để tránh chuỗi sai sót phía sau.
Lộ trình sáu bước: thích nghi từ rẻ đến sâu
Doanh nghiệp không cần khởi đầu bằng một chương trình huấn luyện mô hình. Nên đi từ lớp ít tốn kém, dễ đảo ngược đến lớp đòi hỏi cam kết cao hơn.
Bước 1 — Chọn một quyết định hẹp
Đừng bắt đầu với mục tiêu “xây trợ lý AI toàn công ty”. Hãy chọn một quyết định cụ thể: phân loại yêu cầu hỗ trợ, tìm điều khoản hợp đồng, tóm tắt hồ sơ có trích dẫn, hoặc đề xuất bước xử lý tiếp theo.
Xác định luôn điều gì agent được làm, không được làm và khi nào phải chuyển người.
Bước 2 — Tạo bộ đánh giá trước khi tối ưu
Thu thập tình huống đại diện, ca biên, trường hợp mơ hồ và lỗi có hậu quả cao. Chấm không chỉ “câu trả lời hay”, mà theo các tiêu chí: đúng dữ kiện, đủ nguồn, đúng schema, đúng chính sách, thời gian đáp ứng và chi phí. Cách tiếp cận này gần với việc xây nhiều cổng kiểm tra hơn là chấm AI bằng một bài thi cuối kỳ.
Không có bộ đánh giá, đội dự án chỉ đang tối ưu bằng cảm giác.
Bước 3 — Dùng prompt và ICL để làm rõ chuẩn
Viết chỉ dẫn ngắn, tách vai trò khỏi dữ liệu, cung cấp một vài ví dụ tốt. Nếu đội nghiệp vụ chưa thống nhất thế nào là đầu ra đúng, fine-tuning chỉ đóng băng một cuộc tranh luận chưa kết thúc.
Bước 4 — Thêm RAG khi câu trả lời phụ thuộc tri thức
Quản trị tài liệu trước khi chọn mô hình embedding. Thiết kế metadata, quyền truy cập, hiệu lực, chiến lược chia đoạn và tiêu chí từ chối trả lời. Đo riêng chất lượng truy xuất và chất lượng sinh.
Bước 5 — Fine-tune khi đã có bằng chứng kinh tế
Chỉ tinh chỉnh khi lỗi hành vi vẫn lặp lại, tác vụ đủ ổn định và số lượt chạy đủ lớn để bù chi phí dữ liệu, huấn luyện, đánh giá và vận hành phiên bản. So sánh với baseline, không chỉ với kỳ vọng.
Bước 6 — Grounding và quan sát xuyên suốt
Ghi lại phiên bản prompt, mô hình, tài liệu truy xuất, lời gọi công cụ, phê duyệt và đầu ra cuối. Theo dõi drift của dữ liệu và chất lượng. Mỗi thay đổi kiến trúc phải quay lại bộ đánh giá.
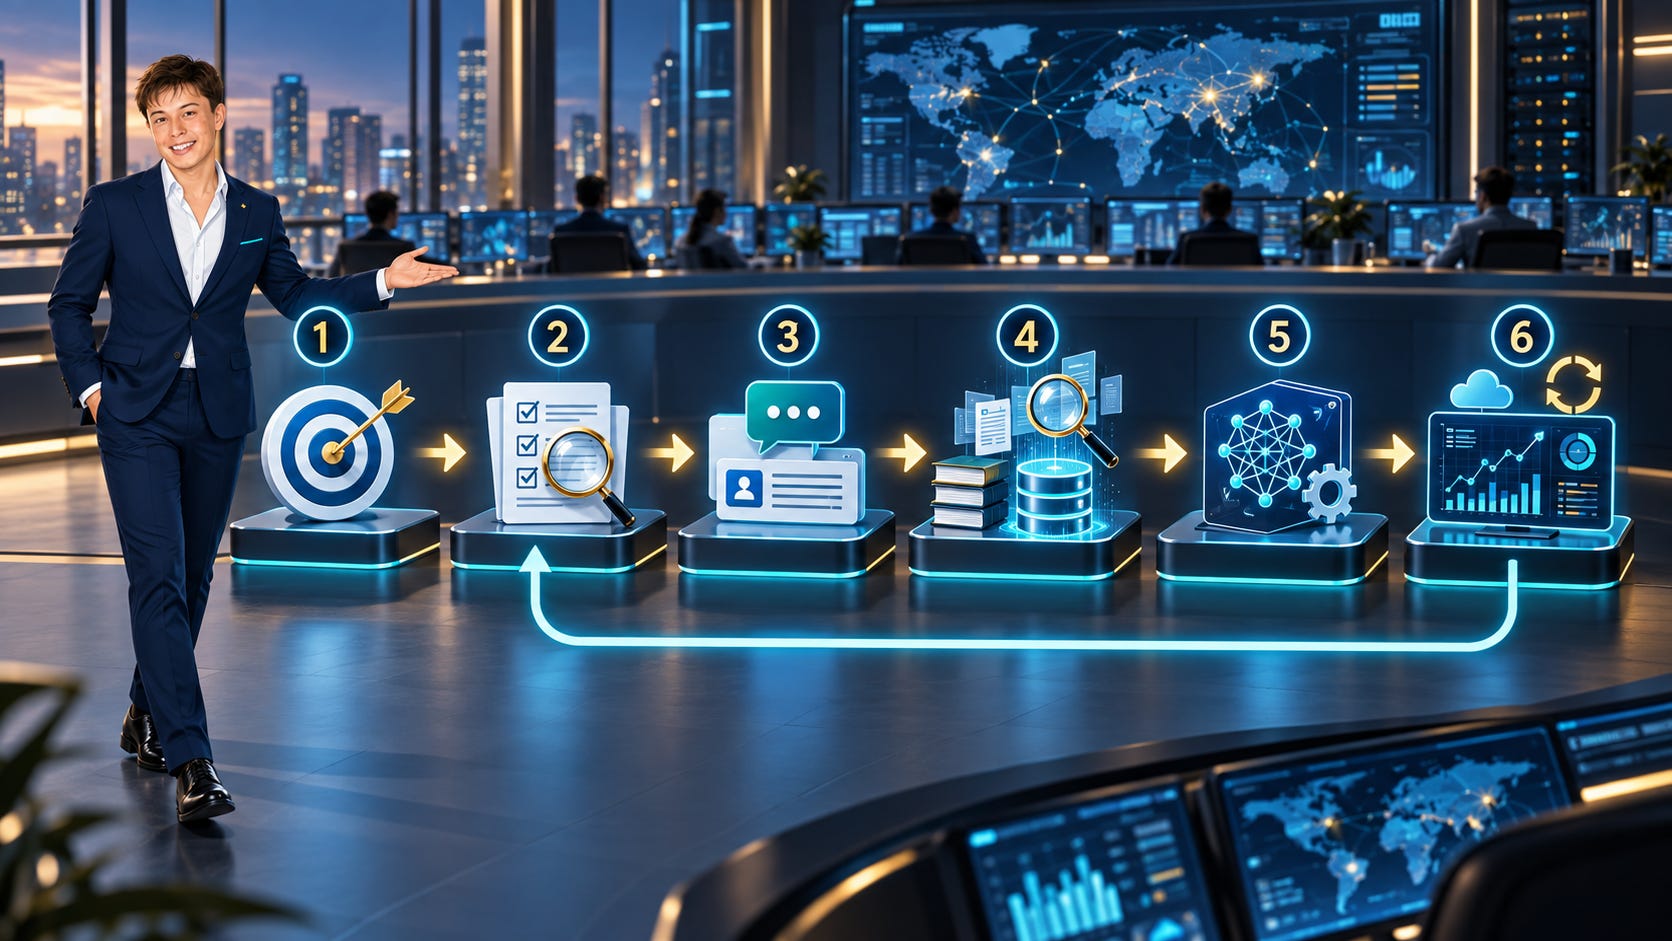
Hình 3 — Đi từ can thiệp nhẹ đến sâu giúp doanh nghiệp kiểm chứng giá trị trước khi tăng mức cam kết.
Ba bẫy kiến trúc thường gặp
Fine-tune để chữa dữ liệu cũ
Khi chính sách thay đổi thường xuyên, kiến thức nhúng vào trọng số nhanh chóng lỗi thời và khó truy vết. Nên giữ dữ kiện động ở lớp truy xuất; dùng fine-tuning cho cách hành xử ổn định.
Đổ toàn bộ tài liệu vào prompt
Nhiều ngữ cảnh hơn không đồng nghĩa nhiều hiểu biết hơn. Nội dung nhiễu làm loãng bằng chứng, tăng chi phí và có thể khiến mô hình bỏ qua chi tiết quan trọng. RAG tốt là đưa đủ đúng, không phải đưa nhiều nhất.
Đo chất lượng ở chatbot nhưng quên quy trình
Một agent có thể trả lời đúng mà vẫn thất bại: gọi nhầm API, vượt quyền, không lưu dấu vết, hoặc không dừng khi thiếu dữ liệu. Chỉ số phải bao phủ cả chuỗi từ truy xuất đến hành động, chứ không dừng ở câu chữ.
Khung quyết định dành cho lãnh đạo
Trước mỗi đề xuất thích nghi LLM, người phê duyệt nên yêu cầu đội dự án trả lời bảy câu hỏi:
Sai số hiện tại thuộc về tri thức, chỉ dẫn, hành vi, hay tích hợp công cụ?
Thông tin cần dùng thay đổi với tần suất nào?
Mọi khẳng định quan trọng có thể truy về nguồn hay không?
Tác vụ đã đủ ổn định để tạo dữ liệu huấn luyện chưa?
Lỗi nào được phép tự sửa, lỗi nào phải chuyển người?
Lợi ích về chất lượng, chi phí và độ trễ được đo trên baseline nào?
Khi tài liệu, prompt hoặc mô hình thay đổi, hệ thống sẽ được kiểm thử hồi quy ra sao?
Nếu bảy câu này chưa có câu trả lời, lựa chọn mô hình chỉ là phần nổi của một kiến trúc chưa hoàn chỉnh.
Lợi thế không nằm trong một mô hình
Các mô hình nền sẽ tiếp tục thay đổi. Một kiến trúc tốt phải cho phép thay mô hình mà không phá vỡ nguồn dữ liệu, quyền truy cập, bộ đánh giá và luồng kiểm soát.
Lợi thế bền vững của doanh nghiệp không nằm ở việc sở hữu prompt dài nhất hay fine-tune sớm nhất. Nó nằm trong năng lực biến tri thức nội bộ thành nguồn có quản trị; biến kinh nghiệm nghiệp vụ thành ví dụ và tiêu chí đánh giá; biến quyền hạn thành ranh giới kỹ thuật; và biến mỗi hành động của agent thành một quyết định có thể giải thích.
RAG, ICL và fine-tuning chỉ thực sự tạo giá trị khi đứng đúng lớp:
RAG mang sự thật hiện hành đến thời điểm cần dùng;
ICL mang hướng dẫn tức thời đến một nhiệm vụ mới;
fine-tuning biến hành vi đã được chứng minh thành năng lực ổn định;
grounding giữ toàn bộ hệ thống gắn với thực tế có thể kiểm chứng.
Đừng hỏi kỹ thuật nào mạnh nhất. Hãy hỏi đâu là can thiệp nhỏ nhất giúp quyết định tiếp theo của hệ thống đáng tin hơn.
RAG, in-context learning và fine-tuning không phải ba lựa chọn thay thế nhau. Bài viết này đề xuất một nguyên tắc thực dụng: thiếu dữ kiện thì truy xuất, thiếu cách làm thì đưa ví dụ, và chỉ tinh chỉnh khi hành vi đã rõ, ổn định và lặp lại đủ nhiều.